Inicio › Capítulos › Capítulo 3 · Implementación y decisiones de negocio
3.4 · Cómo superar los retos de implementar XBRL
22 min de lectura
Juan Carlos Rodríguez R. participó en la elaboración del contenido original de esta sección como desarrollador de contenido de XBRL International. La versión final en inglés es la publicada por XBRL International.
3.4 · Cómo superar los retos de implementar XBRL
Objetivos de aprendizaje
Al terminar esta sección, los lectores podrán:
- Reconocer las barreras prácticas comunes para implementar XBRL en el reporte regulatorio.
- Identificar los obstáculos técnicos, organizacionales y operativos de una implementación de XBRL.
- Evaluar el valor de largo plazo de implementar XBRL.
Introducción
Armar los datos regulatorios sin un marco estructurado es como resolver un rompecabezas complejo sin la imagen de referencia: cada pieza tiene valor, pero sin una guía el panorama completo sigue sin verse claro. Este es el reto que enfrentan los supervisores cuando el reporte es no estructurado o inconsistente. XBRL aporta esa estructura que falta y hace posibles la consistencia, la validación y la automatización en el proceso de reporte.
Sin embargo, adoptar XBRL no es solo una actualización técnica: exige una transformación regulatoria. Desde el fortalecimiento de las capacidades internas hasta la alineación de los sistemas de TI y la coordinación con los grupos de interés, la implementación requiere un enfoque integral y con buen respaldo.
Los supervisores deben anticipar los retos desde temprano, establecer mecanismos de apoyo precisos y asegurar una integración fluida con la infraestructura de supervisión existente. Así se logrará una adopción efectiva y duradera, y se aprovechará todo el potencial del reporte digital estructurado.
Esta sección describe las barreras de implementación más comunes y ofrece estrategias concretas para ayudar a los supervisores a superarlas de manera efectiva.
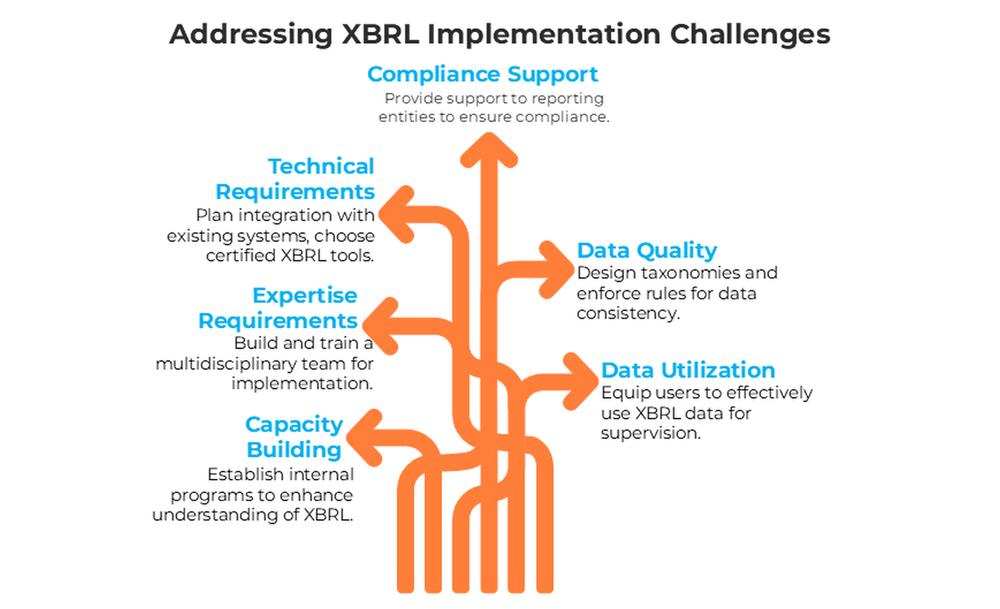
Comprender el estándar XBRL
Para muchos supervisores y entidades que reportan, pasar a XBRL representa un cambio de fondo en la forma de definir, estructurar y validar los datos regulatorios. Mientras que el reporte tradicional puede basarse en documentos estáticos u hojas de cálculo, XBRL exige que cada dato esté vinculado formalmente a un concepto predefinido, con su contexto, sus unidades de medida y su periodo definidos de manera explícita. Este enfoque estructurado mejora la automatización, la validación y la precisión de los análisis, pero también implica una curva de aprendizaje pronunciada para las instituciones que no conocen el estándar.
El núcleo de XBRL es el uso de taxonomías, que funcionan como diccionarios estructurados que definen los elementos de datos requeridos y sus relaciones. Estas taxonomías incluyen reglas sobre la jerarquía de los datos, las etiquetas, los cálculos, las dependencias de contexto y los vínculos con los marcos regulatorios. Los reportes preparados en XBRL deben ceñirse a estas estructuras y superar validaciones automáticas que verifican su consistencia técnica y lógica.
Moverse por las taxonomías y cumplir reglas de validación complejas puede ser un reto para los preparadores de la información. Los malentendidos sobre el uso de la taxonomía, las definiciones de contexto incorrectas o el marcado incompleto suelen llevar a reportes rechazados y a retrasos operativos. Para los supervisores, la falta de experticia interna o una comprensión desigual entre áreas puede entorpecer la implementación y aumentar la carga de soporte.
Establecer programas internos de fortalecimiento de capacidades
Los supervisores deben fortalecer sus capacidades internas mediante capacitación continua a su propio personal. Estas sesiones deben abordar la estructura general y la lógica de las taxonomías y de las reglas de validación, para que los equipos puedan diseñar, adaptar o extender estos componentes según las necesidades regulatorias.
La capacitación debe ajustarse a las responsabilidades de cada rol dentro de la autoridad de supervisión. Por ejemplo, el personal técnico, como los diseñadores de taxonomías y los ingenieros de la plataforma, debe entender cómo se construyen las taxonomías y cómo se implementa la lógica de validación en los sistemas basados en XBRL. Los analistas que participan en la supervisión prudencial o en el monitoreo financiero también deben estar preparados para interpretar datos estructurados con fines de detección de riesgos, evaluación del cumplimiento y análisis de los reportes.
El contenido de la capacitación debe actualizarse de manera continua para reflejar las revisiones de la taxonomía y la evolución de las prioridades regulatorias, de modo que la entidad supervisora conserve la apropiación interna y la comprensión de largo plazo del estándar XBRL.
Crear un repositorio centralizado de conocimiento
Los supervisores deben desarrollar y mantener una plataforma interna de conocimiento que consolide todos los recursos pertinentes para la implementación de XBRL. Este repositorio debe incluir documentos oficiales de orientación, manuales de desarrollo de la taxonomía, referencias de las reglas de validación, cronogramas de implementación, registros internos de decisiones y ejemplos prácticos de experiencias anteriores. También debe recoger las lecciones aprendidas en ciclos de reporte previos, para que el equipo pueda identificar los retos recurrentes y afinar sus procesos internos.
Para apoyar los primeros esfuerzos de implementación, los supervisores pueden incorporar recursos seleccionados de repositorios públicos reconocidos, entre ellos:
- XBRL International Guidance Hub (centro de orientación de XBRL International): ofrece orientación de referencia sobre diseño de taxonomías, reglas de validación, prácticas de presentación y mejores prácticas para diversos casos de uso.
- XBRL International Glossary (glosario de XBRL International): ofrece una lista centralizada de términos y definiciones que ayuda a asegurar una comprensión uniforme entre los equipos técnicos y regulatorios.
- XBRL International – guía How to prepare and publish filing rules (cómo preparar y publicar reglas de reporte): ofrece un marco práctico y listas de verificación detalladas para definir y publicar las reglas de reporte (filing rules) nacionales.
Estos recursos pueden servir de base para el repositorio interno y complementarse progresivamente con contenido desarrollado localmente a medida que avanza la implementación.
Promover un entendimiento común entre los equipos
Para asegurar una implementación coherente de XBRL en toda la organización, los supervisores deben promover un entendimiento común de la taxonomía, de los requerimientos de validación de datos y de lo que se espera de los reportes entre todas las áreas que participan en la supervisión, el soporte técnico y el desarrollo de políticas. Las diferencias de interpretación entre equipos pueden llevar a orientaciones inconsistentes, demoras en la solución de problemas o descuidos en la calidad de los datos.
Esta alineación puede reforzarse con reuniones informativas internas, documentación estructurada y reuniones entre áreas, en especial durante la puesta en marcha de nuevas taxonomías o de actualizaciones de las reglas de validación. Por ejemplo, una regla de validación diseñada para rechazar valores negativos en ciertos campos debe ser entendida con claridad por el equipo técnico (para aplicarla en el sistema) y por el equipo de supervisión (para explicarla al revisar problemas de datos con las entidades). Del mismo modo, los equipos de política deben saber cómo los cambios normativos se traducen en requerimientos de marcado específicos dentro de la taxonomía.
Promover este tipo de coordinación interna asegura una comunicación coherente con las entidades que reportan, mejora la eficiencia operativa y refuerza la credibilidad institucional durante todo el proceso de implementación.
Requerimientos de experticia
Implementar XBRL requiere un conjunto de habilidades multidisciplinario que abarca la regulación, los procesos de negocio y la arquitectura técnica. Para los supervisores, adoptar el estándar va mucho más allá de expedir nuevos requerimientos de reporte: implica diseñar taxonomías que reflejen las necesidades regulatorias, definir reglas de validación, integrar los datos en los sistemas de supervisión y asegurar que el marco siga siendo adaptable en el tiempo.
Sin suficiente experticia interna, los supervisores enfrentan riesgos serios. Las taxonomías mal diseñadas pueden producir datos inconsistentes o inutilizables. Una comprensión débil de las reglas de validación puede dejar vacíos en la exigencia del cumplimiento. Una capacidad técnica insuficiente puede crear cuellos de botella al integrar XBRL con sistemas heredados. Estos vacíos reducen la efectividad de las actividades de supervisión y aumentan la dependencia de apoyo externo en el largo plazo.
Conformar un equipo de implementación multidisciplinario
Los supervisores deben designar formalmente un equipo central responsable de la implementación y el mantenimiento continuo de XBRL. Este equipo debe incluir expertos en política regulatoria, modelado de datos y sistemas de TI. La colaboración entre estos roles es esencial para que las taxonomías reflejen con precisión las obligaciones de reporte, la lógica de validación respalde las prioridades de supervisión y la integración de sistemas cumpla los requisitos de desempeño y seguridad.
Por ejemplo, los expertos en política regulatoria se encargan de interpretar las leyes, las regulaciones y los requerimientos de reporte, y de traducirlos en estructuras conceptuales claras que se reflejen en la taxonomía. Definen qué información debe recolectarse, con qué mandatos legales y cómo debe usarse en el análisis de supervisión.
Los especialistas en modelado de datos (a menudo llamados diseñadores de taxonomías) toman esos requerimientos regulatorios y los convierten en modelos de datos estructurados mediante taxonomías XBRL. Definen los conceptos, las relaciones, las estructuras dimensionales y las reglas de validación que aseguran una interpretación coherente y la comparabilidad entre reportes.
Por su parte, los profesionales de sistemas de TI están a cargo de integrar el marco XBRL en el entorno tecnológico del supervisor. Esto incluye configurar la plataforma de recepción, implementar procesos de validación automática, asegurar un almacenamiento seguro de los datos y permitir la interoperabilidad con herramientas analíticas y bases de datos.
Establecer protocolos de comunicación claros y procesos compartidos de toma de decisiones entre estos roles es crucial para mantener una implementación de XBRL coherente y eficiente.
Invertir en rutas de capacitación especializada
Una vez conformado el equipo multidisciplinario, los supervisores deben apoyar su desarrollo con rutas de capacitación a la medida, que vayan más allá del fortalecimiento general de capacidades. Estas rutas de aprendizaje deben responder a las necesidades de conocimiento específicas de cada rol y permitir un trabajo técnico y estratégico más profundo con el marco XBRL.
Por ejemplo, los diseñadores de taxonomías pueden requerir capacitación en técnicas avanzadas de modelado, como las relaciones dimensionales, los linkbases de fórmulas (formula linkbases) y el manejo de etiquetas multilingües. El personal técnico que trabaja en la infraestructura puede necesitar talleres especializados sobre la integración de motores de procesamiento XBRL, la validación de documentos de instancia a gran escala o la compatibilidad de los sistemas con formatos como iXBRL o xBRL-CSV.
Por su parte, los analistas de política y de supervisión podrían beneficiarse de una capacitación aplicada sobre cómo traducir los requerimientos de reporte en componentes de la taxonomía y cómo interpretar datos estructurados durante el análisis de riesgos o las revisiones de cumplimiento.
Requerimientos técnicos
Implementar XBRL requiere construir un entorno técnico que soporte datos estructurados en todas las etapas del ciclo de vida del reporte. Los supervisores deben poder recibir, validar, almacenar y analizar grandes volúmenes de datos XBRL con altos niveles de confiabilidad, seguridad y desempeño. Si la base técnica es débil, todo el proceso de reporte puede sufrir demoras de procesamiento, validaciones inconsistentes, pérdida de datos o capacidades analíticas limitadas.
La implementación de XBRL implica seleccionar y configurar herramientas especializadas para el desarrollo de la taxonomía, la validación automática de los reportes y una integración fluida con las plataformas de supervisión. El conjunto tecnológico también debe permitir la interoperabilidad con distintos formatos de datos (como iXBRL o xBRL-CSV), el control de versiones de las taxonomías a medida que evolucionan y un almacenamiento escalable para el acceso a los datos en el largo plazo. Sin un diseño cuidadoso y una planeación proactiva, estos componentes técnicos pueden convertirse en cuellos de botella que frenen la adopción y reduzcan la confianza en el sistema de reporte.
Diseñar una arquitectura escalable y segura
Implementar XBRL requiere una arquitectura técnica que soporte todas las etapas del ciclo de reporte: presentación, validación, almacenamiento e integración. En esta etapa, los supervisores deben concentrarse en planear estos componentes centrales, asegurando que la arquitectura sea modular, escalable y segura.
Las funcionalidades clave de la plataforma, como la capa de recepción, el motor de validación, el repositorio de datos estructurados y las herramientas de monitoreo, se tratan en detalle en un artículo aparte.
Lea sobre el diseño de una plataforma de recolección de datos en este artículo.
Seleccionar y validar herramientas XBRL especializadas
Una implementación efectiva de XBRL requiere herramientas que soporten las taxonomías y todas las especificaciones y formatos relacionados, desde los esquemas y los linkbases hasta iXBRL y xBRL-CSV.
Estas herramientas deben permitir la gestión de la taxonomía, ejecutar validaciones frente a reglas técnicas y de negocio, y ofrecer funciones de procesamiento eficientes, como verificaciones masivas y soporte multilingüe. La interoperabilidad con los sistemas internos también es clave para agilizar la supervisión.
Se recomienda a los supervisores elegir soluciones certificadas o probadas en campo, y verificar su desempeño en condiciones reales de uso. Un buen punto de partida es el XBRL Certified Software Directory (directorio de software certificado XBRL).
Asegurar una integración fluida con los sistemas de supervisión
La implementación de XBRL solo tiene sentido cuando los datos se usan activamente. La información validada debe alimentar directamente los sistemas internos del supervisor, como tableros de control, modelos de riesgo y herramientas analíticas.
Esto requiere definir rutas de procesamiento e interfaces de intercambio de datos que transformen y mapeen los datos XBRL a formatos alineados con las necesidades internas. La automatización debe funcionar a la par con el proceso de presentación, para asegurar un acceso oportuno a los hallazgos.
Una capa de integración modular y adaptable ayuda a preparar el sistema para el futuro a medida que evolucionan las taxonomías. La coordinación entre los equipos técnicos y de política es clave para que los datos respondan a las prioridades reales de supervisión.
Planear la adaptabilidad y el mantenimiento de largo plazo
Los entornos XBRL no son estáticos. A medida que evolucionan las taxonomías y cambian los requerimientos de reporte, los supervisores necesitan sistemas que puedan adaptarse sin grandes traumatismos ni costos excesivos.
Esto requiere un gobierno sólido para gestionar las actualizaciones de la taxonomía, comunicar los cambios con claridad, soportar varias versiones cuando sea necesario y retirar de manera ordenada las estructuras obsoletas.
Mantener la integridad del sistema en el largo plazo depende tanto de la coordinación entre áreas como de la disciplina operativa. Los equipos de política y técnicos deben trabajar de la mano para implementar los cambios de manera eficiente, mientras que el monitoreo de indicadores clave de desempeño y la asignación clara de responsabilidades de mantenimiento ayudan a que el sistema siga siendo confiable, seguro y bien soportado.
Al planear el cambio desde el principio, los supervisores pueden reducir el riesgo operativo, ganar flexibilidad y asegurar que XBRL siga siendo una herramienta robusta y efectiva a lo largo del tiempo.
Asegurar el cumplimiento por parte de las entidades que reportan
Un sistema de reporte basado en XBRL solo puede tener éxito si las entidades que reportan entienden lo que se espera de ellas y cumplen con los formatos, las reglas de validación y los procesos de presentación exigidos. Para los supervisores, asegurar el cumplimiento requiere construir un marco estructurado de apoyo y comunicación que facilite la adopción, reduzca los errores de reporte y asegure la entrega oportuna de datos coherentes y de alta calidad.
Sin una orientación accesible y actualizada, las entidades que reportan pueden interpretar mal los elementos de la taxonomía, aplicar contextos incorrectos o presentar datos estructuralmente válidos pero semánticamente inconsistentes. Para evitarlo, los supervisores deben establecer mecanismos proactivos que comuniquen lo que se espera, suministren materiales de referencia y ayuden a las entidades a corregir los errores comunes desde temprano en el proceso.
Apoyo a las entidades que reportan
Los supervisores deben ofrecer una orientación de cumplimiento clara y práctica, dar ejemplos concretos y herramientas pensadas para los preparadores de la información, mantener una comunicación continua para detectar problemas a tiempo, apoyar la validación previa a la presentación para prevenir errores, y definir y comunicar con claridad los procedimientos de exigibilidad (enforcement), para asegurar un reporte coherente y de alta calidad.
Lea sobre cómo involucrar y apoyar a las entidades que reportan en este artículo.
Asegurar la calidad y la consistencia de los datos
El reporte estructurado con XBRL ofrece una oportunidad importante para mejorar la calidad, la comparabilidad y la confiabilidad de los datos regulatorios. Sin embargo, la alta calidad de los datos no está garantizada: depende de cómo se diseñen las taxonomías, de cómo se implementen las reglas de validación y de qué tan coherentemente apliquen el estándar las entidades que reportan. Los supervisores deben cumplir un papel proactivo en la construcción de estas bases y en su mantenimiento en el tiempo.
Las ambigüedades en las definiciones de la taxonomía, el uso inconsistente de los contextos o unos criterios de validación laxos pueden socavar la integridad de los reportes presentados, lo que vuelve menos efectivo el análisis regulatorio y exige intervención manual adicional. Para evitar estos resultados, los supervisores deben aplicar un marco de calidad de datos que combine una arquitectura sólida de la taxonomía, reglas de negocio estrictas y mecanismos de retroalimentación focalizados.
Diseñar taxonomías que favorezcan la claridad y la consistencia
Las taxonomías deben estructurarse de modo que reflejen con claridad la lógica regulatoria, ya sea que sigan patrones jerárquicos de información a revelar (divulgación) o que se construyan como modelos planos de puntos de datos (data point models). En cualquier caso, los supervisores deben priorizar definiciones claras de los conceptos, un uso coherente de las dimensiones y una agrupación intuitiva de los puntos de datos para reducir la ambigüedad y los errores de clasificación. El modelado dimensional solo debe aplicarse cuando mejore la precisión del reporte, y debe evitarse la redundancia de conceptos.
Involucrar a los preparadores de la información y a expertos en la materia durante el diseño de la taxonomía asegura que la estructura, cualquiera que sea el enfoque de modelado, esté alineada con los procesos reales de reporte y sea interpretable tanto por personas como por máquinas.
El versionamiento también debe gestionarse con cuidado. Cuando se introducen actualizaciones de la taxonomía, los supervisores deben comunicar con claridad qué cambios se hicieron, cómo afectan a los reportes existentes y qué ajustes se esperan de las entidades que reportan.
Implementar una validación sólida y hacer cumplir las reglas de negocio
XBRL permite la validación automática, pero su efectividad depende de la profundidad y la pertinencia de las reglas que defina el supervisor. Las reglas de reporte (filing rules) deben ir más allá de verificar la sintaxis y la estructura, y reflejar las expectativas reales de la supervisión.
Los resultados de la validación no solo deben aceptar o rechazar los reportes, sino también producir mensajes de error significativos, que ayuden a los preparadores a resolver los problemas con rapidez y a los supervisores a concentrarse en los riesgos materiales.
Lea más sobre la validación de datos XBRL en este artículo.
Promover el uso de enumeraciones y definiciones estándar
Los valores categóricos, como los códigos de moneda, los segmentos de negocio o las clasificaciones de riesgo, deben basarse en listas controladas y administradas de forma centralizada, también conocidas como enumeraciones. Estas listas evitan las entradas de texto libre que podrían introducir variaciones, errores de ortografía o etiquetas inconsistentes, que reducen la calidad y la comparabilidad de los datos reportados.
Por ejemplo, en lugar de permitir que las entidades escriban su moneda de reporte como texto libre («pesos», «pesos colombianos», «COP$»), la taxonomía debe obligar a seleccionarla de una enumeración predefinida, como:
- COP – Peso colombiano
- USD – Dólar estadounidense
- EUR – Euro
- …
Esto asegura un marcado coherente en todos los reportes y facilita la validación automática y la agregación de los datos categóricos. Los supervisores deben asegurarse de que estas enumeraciones estén referenciadas correctamente en la taxonomía y documentadas con claridad en el manual de presentación o en la guía para preparadores.
Uso de los datos XBRL para una supervisión y un análisis efectivos
Una vez que los datos XBRL se han recolectado y validado con éxito, su valor está en hacer posible una supervisión informada, la evaluación de políticas y el análisis de riesgos. Para que esto ocurra, los supervisores deben asegurarse de que los datos estructurados se transformen en información significativa, accesible y útil para actuar. Esto requiere una estrategia deliberada que incluya las herramientas, las habilidades y la coordinación interna adecuadas.
Con demasiada frecuencia, los proyectos XBRL se concentran en la recolección y la validación sin considerar a fondo cómo se consumirán los datos. Para evitarlo, la generación de reportes y el análisis deben integrarse al diseño del sistema de reporte desde el principio.
Preparar a los usuarios de los datos para moverse por los datos XBRL
Una vez que los datos se han recolectado mediante un sistema basado en XBRL, los analistas y los equipos de supervisión deben poder consultarlos con precisión. Esto requiere entender con claridad cómo está organizada la información dentro de la taxonomía y cómo las dimensiones, los contextos y las variaciones propias de cada entidad influyen en la forma en que se almacenan los hechos.
Por ejemplo, extraer una métrica sencilla como la «utilidad neta» puede implicar filtrar los hechos no solo por concepto, sino también por tipo de periodo (duración), entidad que reporta, desagregación dimensional (por ejemplo, consolidado frente a individual) y punto de entrada de la taxonomía aplicable. Si los usuarios no conocen estas capas, pueden interpretar mal los datos o pasar por alto información a revelar pertinente.
Para evitarlo, los supervisores deben entregar a los usuarios de los datos guías de consulta u hojas de mapeo que expliquen cómo ubicar datos específicos dentro de la estructura de la taxonomía. Estas guías pueden incluir:
- Consultas de ejemplo con conceptos y filtros estándar.
- Explicaciones de los contextos o las combinaciones dimensionales más comunes.
- Ejemplos de los indicadores consultados con más frecuencia y de cómo reconstruirlos a partir de los datos.
Este enfoque asegura que los analistas no traten el conjunto de datos como una tabla plana, sino como un grafo estructurado que requiere una navegación según el contexto. Darles a los usuarios la capacidad de acceder a los datos con precisión aumenta la confianza en el sistema y mejora la calidad de los hallazgos.
Lea más sobre el análisis de datos XBRL en este artículo.
Definir productos de reporte alineados con los objetivos regulatorios
Antes de construir tableros de control o herramientas de análisis, los supervisores deben definir las preguntas clave que los datos deben responder. Estas pueden incluir indicadores de alerta temprana, puntajes de cumplimiento o la exposición a riesgos ambientales. Tener un propósito claro permite estructurar mejor los conjuntos de datos extraídos y respalda una lógica de transformación focalizada.
Ofrecer tableros de control interactivos y adaptados a cada usuario
Las distintas áreas del supervisor pueden necesitar perspectivas diferentes sobre el mismo conjunto de datos. Los tableros de control interactivos, que permiten filtrar por periodo de reporte, tipo de institución o punto de entrada de la taxonomía, les permiten a los usuarios profundizar en los detalles y generar sus propios hallazgos. Estos tableros deben reflejar la estructura lógica de los datos tal como está definida en la taxonomía y respetar los requisitos de confidencialidad que apliquen.
Pueden verse ejemplos de tableros de control construidos con información financiera basada en XBRL presentada en Colombia a la Superintendencia de Sociedades en el informe de las 1.000 empresas más grandes del país o en el resumen por regiones del Sistema Integrado de Información Societaria (SIIS). Además, puede explorarse aquí un ejemplo de tablero de sostenibilidad basado en información a revelar en XBRL presentada en la India.
Cerrar el ciclo entre los usuarios de los datos y los equipos de taxonomía
Una vez que los datos se analizan y se presentan en tableros de control o en informes regulatorios, suelen surgir lecciones importantes, no solo sobre las tendencias de riesgo, sino también sobre qué tan bien soporta la taxonomía los análisis que se buscan. Los supervisores deben establecer canales internos de retroalimentación entre los equipos analíticos y los diseñadores de taxonomías, para que la estructura de reporte evolucione según las necesidades prácticas de datos.
Por ejemplo, supongamos que un tablero muestra los gastos operacionales por área en las distintas entidades. Si los analistas informan con frecuencia que faltan datos o que están marcados de forma inconsistente en la categoría «Otros gastos», esto puede indicar una falta de granularidad en la taxonomía o confusión en la interpretación de los preparadores. Con base en este hallazgo, el equipo de taxonomía podría introducir conceptos nuevos y específicos (por ejemplo, «Servicios de TI» y «Costos de mercadeo») o actualizar la orientación para aclarar el uso de los valores dimensionales.
Estos mecanismos de retroalimentación mejoran tanto la precisión del reporte como la confiabilidad de los indicadores monitoreados, y fortalecen la calidad y el valor generales del ecosistema de datos.
Resumen
Implementar XBRL con éxito implica alinear los objetivos regulatorios, la infraestructura técnica y las prácticas operativas mediante un esfuerzo coordinado y estratégico. Aunque la transición introduce nuevas complejidades, ofrece una oportunidad clara para modernizar la supervisión, mejorar la calidad de los datos y reducir los costos de reporte en el largo plazo.
Los supervisores cumplen un papel crucial en este éxito. Invertir en capacidad interna, definir con claridad lo que se espera en materia de cumplimiento, apoyar a los preparadores de la información con orientación y comunicación, y asegurar que los sistemas sean técnicamente robustos y útiles para el análisis son componentes esenciales de una implementación sostenible.
La adopción no es un hito que se alcanza una sola vez. A medida que evolucionan los marcos regulatorios, las taxonomías deben adaptarse, la lógica de validación debe seguir alineada con las prioridades de supervisión y la retroalimentación de los preparadores y los analistas debe impulsar la mejora continua.
Aunque las primeras etapas de la implementación pueden parecer intensivas en recursos, XBRL reduce de manera significativa las ineficiencias del reporte manual: minimiza los errores de digitación, acelera la validación y permite el análisis en tiempo real. Estos beneficios se acumulan con el tiempo y convierten los datos regulatorios en un activo poderoso.
Al abordar de forma proactiva los retos clave y enfocarse en el valor de largo plazo del sistema, los supervisores pueden lograr que XBRL se convierta en un catalizador de una regulación más inteligente, de mejores decisiones y de un entorno de supervisión más ágil y basado en datos.
Texto original en inglés: https://playbook.xbrl.org/