Inicio › Capítulos › Capítulo 6 · Recolección, almacenamiento y análisis de datos
6.4 · Desarrollo de sistemas analíticos para datos XBRL
40 min de lectura
6.4 · Desarrollo de sistemas analíticos para datos XBRL
Objetivos de aprendizaje
- Comprender cómo establecer objetivos claros para los sistemas analíticos de datos, alineados con los requisitos de los usuarios.
- Analizar los componentes del sistema propios de XBRL, incluidas la estructura de la taxonomía y la documentación de las reglas de reporte (filing rules).
- Aprovechar los elementos estructurales de XBRL, incluidas las relaciones de presentación y las capacidades de análisis dimensional.
- Aplicar la inteligencia de las taxonomías XBRL a marcos existentes, como la información a revelar (divulgación) de las ESRS.
- Comprender cómo usar las taxonomías de reporte de supervisión con fines analíticos regulatorios.
Introducción
Construir sistemas analíticos capaces de procesar y analizar de manera efectiva los datos XBRL reportados, como los reportes de sostenibilidad, exige un enfoque sistemático que empieza con objetivos claros y avanza mediante una evaluación cuidadosa de las características de los datos y de los requisitos de los usuarios. La complejidad de los datos empresariales, que pueden ir desde información numérica muy estructurada hasta contenido narrativo no estructurado, exige un diseño de sistema bien pensado, que ajuste las capacidades analíticas a los tipos de datos y a las necesidades de los usuarios.
Establecer objetivos analíticos claros
La base de cualquier sistema analítico efectivo está en definir con claridad lo que el sistema debe lograr. Estos objetivos deben desprenderse directamente de las políticas, las regulaciones y el mandato establecidos del receptor de datos. Un supervisor financiero que construye un sistema analítico tendrá objetivos distintos de los de un regulador de valores, una agencia ambiental o una unidad de formulación de políticas, aun cuando todos trabajen con fuentes de datos de sostenibilidad similares.
Definir los objetivos analíticos requiere comprender tanto las necesidades analíticas inmediatas como las metas estratégicas de más largo plazo de la institución. Las necesidades inmediatas podrían incluir el seguimiento del cumplimiento de requisitos específicos de información a revelar, la identificación de tendencias en determinadas métricas de sostenibilidad o el apoyo a las evaluaciones de supervisión periódicas. Los objetivos estratégicos podrían abarcar el desarrollo de nuevas iniciativas de política, el apoyo a los esfuerzos de cooperación internacional o la construcción de capacidades para los retos analíticos emergentes.
Comprender los requisitos de los usuarios y los escenarios analíticos
Una vez establecidos los objetivos, el siguiente paso crítico consiste en reunir de manera sistemática los requisitos de los usuarios del sistema analítico. Este proceso debe identificar los escenarios analíticos específicos que los usuarios necesitan atender, los indicadores clave de desempeño que deben monitorear, los tipos de agregación de datos requeridos y sus preferencias de visualización de datos y de reporte.
Los distintos grupos de usuarios dentro de una misma organización suelen requerir capacidades analíticas diferentes. Los altos responsables de políticas podrían necesitar tableros de control (dashboards) de alto nivel que resuman las tendencias de sectores completos, mientras que el personal técnico que hace evaluaciones detalladas podría requerir la posibilidad de profundizar en la información a revelar de cada empresa y comparar datos específicos entre varias entidades. Comprender estos requisitos variados desde temprano en el diseño del sistema evita modificaciones costosas más adelante.
Analizar los componentes del sistema propios de XBRL
Cuando se construyen sistemas analíticos basados en datos XBRL, se hace necesario un análisis adicional para comprender las características específicas del marco de reporte que se usa. Este paso debe examinar la estructura de la taxonomía XBRL, que define los conceptos, las relaciones y las reglas de validación que rigen los datos reportados. Comprender cómo organiza la taxonomía la información aporta claves cruciales para diseñar procesos analíticos que aprovechen de manera efectiva las relaciones estructuradas incorporadas en los datos.
La documentación de las reglas de reporte es otro insumo esencial para el diseño del sistema. Estas reglas definen los requisitos técnicos, los criterios de validación y los procesos de envío que afectan la forma en que los datos se recolectan y se almacenan. Comprender estas reglas ayuda a asegurar que los sistemas analíticos puedan interpretar correctamente los datos recolectados e identificar cualquier problema de calidad de datos que pueda afectar los resultados analíticos.
El mecanismo de identificación de las entidades que reportan también requiere análisis, en particular cuando se construyen sistemas que deben hacer seguimiento a las entidades a lo largo de varios periodos de reporte o vincular los datos de sostenibilidad con otra información regulatoria. Este análisis debe abordar cómo funciona la identificación de entidades dentro del sistema objetivo y cómo se mantienen en el tiempo las relaciones entre entidades.
Evaluar la naturaleza y las características de formato de los datos
El diseño de los sistemas analíticos depende de comprender la naturaleza y las características de formato de los datos de origen. La información a revelar regulatoria plantea retos particulares, porque puede abarcar varios formatos de datos, cada uno de los cuales requiere enfoques distintos de procesamiento, almacenamiento y análisis.
Los datos estructurados con metadatos ricos representan la categoría de información más sofisticada. El reporte XBRL ofrece un marcado detallado de cada valor numérico, con metadatos completos definidos en las taxonomías que explican el significado, el contexto y las relaciones de cada dato. Esta estructura rica habilita capacidades analíticas sofisticadas, entre ellas la validación automatizada, el análisis dimensional y las agregaciones complejas basadas en las relaciones de la taxonomía.
XBRL también admite el marcado en bloque de la información narrativa, que captura contenido no estructurado, como textos descriptivos y tablas, dentro de un marco estructurado. Aunque la estructura general sigue siendo legible por máquinas, el contenido en sí requiere enfoques analíticos distintos de los de los datos puramente numéricos.
Otros formatos estructurados con metadatos ricos, como los datos basados en las normas ISO 20022, ofrecen diccionarios de definiciones detallados que explican el significado de los datos y sus relaciones. Estas normas permiten un procesamiento sofisticado y, al mismo tiempo, mantienen la claridad sobre la semántica de los datos.
Los datos estructurados sin metadatos plantean retos analíticos diferentes. Formatos como los archivos JSON, XML o CSV pueden organizar la información en estructuras predecibles, pero, sin diccionarios técnicos ni documentación adicionales, comprender el significado de los datos y sus relaciones se vuelve más difícil. Estos formatos obligan a los analistas a inferir la semántica de los datos a partir del contexto o a elaborar documentación aparte que explique su significado.
Los formatos no estructurados, como los documentos PDF, representan la categoría más difícil para el análisis automatizado. Aunque estos formatos conservan una presentación legible por humanos, extraer datos específicos con fines analíticos requiere técnicas de procesamiento especializadas y a menudo implica cierto grado de interpretación manual.
Ajustar los enfoques de almacenamiento y análisis a los tipos de datos
Cada tipo de formato de datos requiere enfoques distintos de extracción, almacenamiento y análisis. Comprender estos requisitos desde temprano en el diseño del sistema ayuda a asegurar que la infraestructura técnica pueda soportar de manera efectiva las capacidades analíticas previstas.
Los datos numéricos con metadatos ricos se benefician de sistemas de almacenamiento capaces de conservar y aprovechar las relaciones de los metadatos. Los sistemas tradicionales de bases de datos relacionales, equipados con software de inteligencia de negocios (BI), ofrecen capacidades robustas de manipulación, agregación y presentación de datos cuando se trabaja con información numérica bien estructurada. Estos sistemas sobresalen en las operaciones analíticas estándar, como el análisis de tendencias, las evaluaciones comparativas y los cálculos estadísticos.
Los datos no numéricos, en particular el contenido narrativo descriptivo, requieren un enfoque analítico más sofisticado. Las herramientas tradicionales de inteligencia de negocios, diseñadas para el análisis numérico, no pueden procesar de manera efectiva el contenido narrativo, que puede contener información cualitativa crucial sobre el desempeño en sostenibilidad, los enfoques de gestión de riesgos o las intenciones estratégicas.
Los enfoques analíticos modernos incorporan cada vez más los grandes modelos de lenguaje y otras tecnologías de inteligencia artificial para analizar de manera sistemática el contenido narrativo. Estas herramientas pueden identificar temas y sentimientos, extraer información específica, comparar enfoques entre varias entidades e incluso evaluar la consistencia entre las descripciones narrativas y los datos numéricos de desempeño.
La elección entre los enfoques tradicionales de inteligencia de negocios y las soluciones más modernas basadas en IA suele depender del equilibrio entre contenido numérico y narrativo en los datos, de la complejidad de las preguntas analíticas que se plantean y de las capacidades técnicas disponibles en la organización.
Consideraciones de integración
Los sistemas analíticos efectivos a menudo necesitan integrar varias fuentes de datos y enfoques analíticos. Un sistema analítico completo podría combinar datos numéricos estructurados, procesados con herramientas tradicionales de inteligencia de negocios, con contenido narrativo analizado con enfoques basados en IA, complementados con fuentes de datos externas que aporten contexto o información de referencia (benchmarking).
Esta integración exige prestar mucha atención a la calidad de los datos, a la correspondencia de entidades entre las distintas fuentes y a mantener la consistencia de los resultados analíticos, pese a que se usen enfoques de procesamiento diferentes para tipos de datos diferentes. El diseño del sistema también debe prever su ampliación futura, a medida que aparezcan nuevas fuentes de datos o evolucionen los requisitos analíticos.
Construir sistemas analíticos efectivos para datos XBRL representa un reto técnico y analítico importante, pero comprender el enfoque sistemático descrito arriba sienta las bases para desarrollar capacidades que apoyen de manera efectiva los objetivos regulatorios y de política, a la vez que se adaptan a las diversas características de la información recolectada.
Lea sobre el almacenamiento y la protección de los reportes XBRL en este artículo.
Aprovechar la estructura de XBRL para análisis avanzados
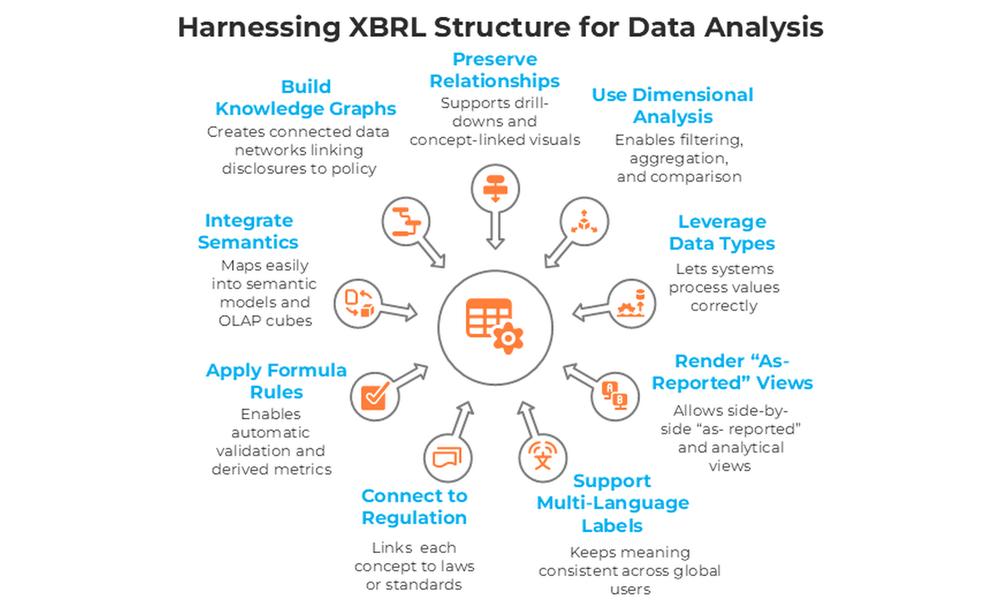
Construir sistemas analíticos que aprovechen de manera efectiva los datos XBRL depende de comprender cómo extraer y usar la rica información estructural incorporada en las taxonomías y los reportes XBRL. A diferencia de los formatos de datos simples, que solo contienen valores en bruto, XBRL ofrece metadatos completos, relaciones y definiciones semánticas que pueden mejorar de manera significativa las capacidades analíticas cuando se incorporan adecuadamente en el diseño del sistema.
El principio clave de los sistemas analíticos efectivos basados en XBRL consiste en conservar y aprovechar las relaciones estructuradas definidas en las taxonomías, en lugar de tratar los datos XBRL como una fuente más de valores numéricos. Este enfoque permite que los sistemas analíticos mantengan el significado semántico y la complejidad dimensional que hacen a XBRL particularmente valioso para el análisis regulatorio y de políticas.
Uso de las relaciones de presentación y de definición
Las relaciones de presentación (o árbol de presentación) de las taxonomías XBRL definen relaciones jerárquicas entre conceptos que reflejan cómo debe organizarse y mostrarse la información. Estas relaciones ofrecen una base para construir tableros de control analíticos y presentaciones tabulares que mantengan la estructura lógica inherente a los datos reportados.
Al diseñar interfaces analíticas, las relaciones de presentación pueden orientar el desarrollo de capacidades de profundización (drill-down), que permiten a los usuarios navegar desde la información resumida hasta los componentes detallados, manteniendo las relaciones conceptuales definidas en la taxonomía. Este enfoque asegura que las presentaciones analíticas reflejen el significado y la estructura previstos de la información reportada, en lugar de imponer esquemas de organización arbitrarios.
El linkbase de definición cumple propósitos distintos pero complementarios, pues define las relaciones lógicas entre conceptos. Estas relaciones resultan particularmente valiosas para construir visualizaciones analíticas que muestren cómo interactúan o cambian en el tiempo los distintos elementos. Por ejemplo, al analizar los cambios en la situación financiera o en las métricas de sostenibilidad, las relaciones de definición ayudan a asegurar que las presentaciones analíticas reflejen con precisión las conexiones conceptuales subyacentes entre los distintos elementos de datos.
Aprovechar las capacidades de análisis dimensional
La estructura dimensional de XBRL ofrece capacidades sofisticadas para filtrar, agregar y analizar datos a lo largo de varias dimensiones al mismo tiempo. Las dimensiones y los miembros de dominio correspondientes pueden incorporarse de manera sistemática en los sistemas analíticos para ofrecer capacidades flexibles de filtrado y agregación.
Las dimensiones permiten a los usuarios ver los mismos datos subyacentes desde varias perspectivas sin perder la información de contexto que da significado a valores específicos. Una misma métrica de sostenibilidad podría reportarse para varias regiones geográficas, segmentos de negocio o periodos. La estructura dimensional conserva estas distinciones y, a la vez, permite que los sistemas analíticos agreguen o desagreguen la información según se necesite para distintos propósitos analíticos.
Esta capacidad dimensional resulta particularmente valiosa para calcular agregados a partir de los datos de varias empresas. Cuando las empresas reportan con estructuras dimensionales consistentes, los sistemas analíticos pueden hacer agregaciones significativas que mantienen la consistencia semántica. Esto permite el análisis sectorial, la comparación con referentes (benchmarking) y la identificación de tendencias, que serían difíciles o imposibles con formatos de datos menos estructurados.
Comprender las características de los datos mediante las definiciones de tipos
Las taxonomías XBRL incluyen definiciones detalladas de tipos de datos que especifican la naturaleza y las características de cada pieza de información. Estas definiciones ayudan a los sistemas analíticos a entender cómo procesar, validar y presentar adecuadamente los distintos tipos de datos.
Los valores monetarios requieren un procesamiento distinto del de los porcentajes, las fechas o las descripciones de texto. Las definiciones de tipos de datos aseguran que los sistemas analíticos puedan aplicar el formato, las reglas de validación y las operaciones analíticas adecuadas a cada elemento de datos. Esta comprensión evita errores analíticos que podrían surgir de tratar de manera inadecuada los distintos tipos de datos.
Conservar la presentación original mediante las plantillas de reporte XBRL
Las plantillas de reporte XBRL (Table Linkbase) permiten crear diseños complejos que admiten desgloses multidimensionales y patrones de presentación sofisticados. Esta capacidad resulta valiosa para los sistemas analíticos que necesitan mostrar los datos en formatos que coincidan con los reportes empresariales originales, manteniendo la estructura dimensional subyacente.
Esta funcionalidad permite que los sistemas analíticos presenten vistas de los reportes empresariales tal como fueron reportados, junto a presentaciones analíticas más tradicionales. Los usuarios pueden examinar cómo presentaron originalmente las empresas su información y, a la vez, acceder a los datos estructurados para el análisis comparativo. Esta doble capacidad apoya tanto la revisión detallada de reportes individuales como el análisis sistemático entre varias entidades.
Apoyo al análisis en varios idiomas y en varios contextos
Las etiquetas de las taxonomías XBRL admiten varios idiomas y tipos de etiqueta, lo que permite a los sistemas analíticos presentar la información en distintos idiomas manteniendo la consistencia semántica. Esta capacidad resulta esencial para los sistemas regulatorios internacionales que necesitan analizar datos reportados en varios idiomas o que atienden a usuarios que trabajan en distintos idiomas.
Los múltiples tipos de etiqueta también permiten que los sistemas analíticos presenten la información con distintos niveles de detalle o para distintos públicos. Las etiquetas técnicas podrían ofrecer definiciones precisas para usuarios especialistas, mientras que las etiquetas estándar ofrecen descripciones más accesibles para el público general.
Incorporar el contexto regulatorio y legal
Las referencias asocian los conceptos con citas de la literatura autorizada, lo que permite a los sistemas analíticos mantener las conexiones entre los datos reportados y las normas regulatorias o contables subyacentes que definen los requisitos de reporte. Esta capacidad apoya la construcción de grafos de conocimiento que vinculan los conceptos financieros y de sostenibilidad con sus fundamentos regulatorios.
Estas conexiones permiten que los sistemas analíticos aporten contexto sobre por qué se reporta determinada información y cómo se relaciona con marcos regulatorios más amplios. Los usuarios pueden entender no solo lo que reportaron las empresas, sino también la lógica regulatoria detrás de requisitos específicos de información a revelar. También pueden acceder al texto completo de la regulación o la política subyacente que está asociada a determinados hechos reportados.
Habilitar la validación avanzada y los análisis derivados
Las reglas de fórmulas XBRL (XBRL formula) ofrecen mecanismos estandarizados para definir reglas de validación y cálculos derivados dentro de las taxonomías. Estas capacidades pueden aprovecharse con fines analíticos que van más allá de la validación básica e incluyen el análisis de patrones y la identificación de tendencias.
Los enfoques basados en fórmulas permiten que los sistemas analíticos generen métricas derivadas, identifiquen inconsistencias entre datos relacionados y apliquen reglas de negocio sofisticadas que reflejan las expectativas regulatorias. Esta capacidad transforma las taxonomías de simples definiciones de datos en marcos analíticos activos que pueden apoyar análisis regulatorios complejos.
Integración con sistemas semánticos y OLAP
La naturaleza estructurada de los datos XBRL permite su integración con herramientas de modelado semántico y con sistemas de procesamiento analítico en línea (OLAP), que pueden ofrecer capacidades analíticas sofisticadas. El modelo abierto de información de XBRL, Open Information Model (OIM), permite establecer correspondencias entre los datos XBRL y otros marcos semánticos, de modo que los sistemas analíticos puedan aprovechar herramientas analíticas avanzadas conservando el significado incorporado en las estructuras XBRL.
Los marcos avanzados de correspondencia (mapping) pueden manejar la heterogeneidad que existe entre los distintos reportes XBRL y mantener la consistencia analítica. Esta capacidad permite que los sistemas analíticos trabajen de manera efectiva con datos de varias taxonomías o periodos de reporte, conservando la comparabilidad.
Construir grafos de conocimiento para el análisis regulatorio
La combinación de referencias, definiciones de conceptos y relaciones estructuradas dentro de las taxonomías XBRL sienta las bases para construir grafos de conocimiento que conecten los datos reportados con marcos regulatorios y de política más amplios. Estos grafos de conocimiento pueden apoyar consultas analíticas sofisticadas que abarquen varios ámbitos de interés regulatorio.
Los enfoques basados en grafos de conocimiento permiten que los sistemas analíticos respondan preguntas complejas sobre las relaciones entre los datos reportados, los requisitos regulatorios, los objetivos de política y las tendencias económicas o ambientales más amplias. Esta capacidad transforma los datos XBRL de información de reporte aislada en un recurso de conocimiento conectado que puede apoyar un análisis regulatorio integral.
El uso sistemático de estos elementos estructurales de XBRL permite sistemas analíticos más sofisticados, semánticamente consistentes y analíticamente potentes que los sistemas que tratan a XBRL como un formato de datos más. Comprender e implementar estas capacidades se vuelve esencial para construir sistemas analíticos que aprovechen plenamente la inversión en programas de reporte basados en XBRL.
Caso de estudio: análisis de la información a revelar de las ESRS con la inteligencia de la taxonomía XBRL
Cómo aprovechar la información de la taxonomía XBRL para diseñar sistemas analíticos se entiende mejor al examinar escenarios de implementación específicos. La taxonomía XBRL de las Normas Europeas de Información sobre Sostenibilidad (European Sustainability Reporting Standards) ofrece un ejemplo completo de cómo una estructura de taxonomía detallada puede orientar el desarrollo de sistemas analíticos y mejorar las capacidades de supervisión.
Estructura de la taxonomía XBRL de las ESRS e implicaciones analíticas
Las normas de reporte European Sustainability Reporting Standards (ESRS), desarrolladas bajo la Interoperable Taxonomy Architecture (arquitectura de taxonomía interoperable), muestran cómo los marcos modernos de reporte de sostenibilidad pueden ofrecer datos estructurados que soporten capacidades analíticas sofisticadas. La taxonomía define varios tipos de datos que requieren enfoques analíticos distintos, y cada uno aporta conocimientos diferentes para el análisis de supervisión y regulatorio.
Esta diversidad de tipos de datos dentro de un mismo marco de reporte ilustra por qué los sistemas analíticos deben diseñarse para manejar varios formatos de información, manteniendo las relaciones semánticas definidas en la taxonomía. Los supervisores pueden aprovechar la estructura de la taxonomía para entender no solo qué información reportan las empresas, sino también cómo se relacionan entre sí las distintas piezas de información y qué enfoques analíticos resultan más efectivos para cada tipo de datos.
Datos numéricos que soportan cálculos de KPI
La taxonomía incluye conceptos como «Non-renewable energy production» (producción de energía no renovable), cuyo tipo de datos está definido como «energy item» (dtr-types:energyItemType) en la ESRS E1-5. Esta clasificación indica que el dato representa mediciones de energía que alimentan cálculos de sostenibilidad más amplios, en lugar de ser métricas finales por sí mismas.
Para los sistemas analíticos, esta información de la taxonomía indica que esos datos deben diseñarse con fines de agregación y cálculo. Los supervisores pueden aprovechar esta comprensión para construir capacidades analíticas que identifiquen automáticamente las relaciones entre los datos subyacentes y las métricas derivadas, lo que permite evaluaciones de calidad que verifican si los KPI reportados concuerdan con sus elementos de datos componentes. La definición del tipo de datos también asegura que los sistemas analíticos apliquen las unidades, las reglas de validación y los métodos de agregación adecuados al procesar información relacionada con la energía.
Indicadores clave de desempeño con mediciones complejas
Conceptos como «Energy intensity from activities in high climate impact sectors (measured as total energy consumption per net revenue)» (intensidad energética de las actividades en sectores de alto impacto climático, medida como consumo total de energía por ingresos netos), cuyo tipo de datos está definido como «energy per monetary item» (dtr-types:energyPerMonetaryItemType) en la ESRS E1-5, representan métricas calculadas que combinan distintos tipos de medición. Esta definición del tipo de datos indica que el valor representa un consumo de energía normalizado por montos monetarios.
La estructura de la taxonomía permite que los sistemas analíticos entiendan la naturaleza compuesta de esas métricas y diseñen análisis comparativos adecuados. Los supervisores pueden usar esta información para construir capacidades analíticas que interpreten correctamente las métricas de intensidad, las comparen entre entidades de distinto tamaño e identifiquen valores atípicos que podrían indicar errores de reporte o circunstancias excepcionales. La relación definida en la taxonomía entre las mediciones de energía y las monetarias también permite que los sistemas analíticos hagan comparaciones con referentes (benchmarking) significativas, teniendo en cuenta las diferencias de escala entre entidades.
Análisis de la información a revelar narrativa
Los conceptos de bloque de texto, como «Description of key contents of policy [text block]» (descripción de los contenidos clave de la política [bloque de texto]), cuyo tipo de datos está definido como text block item (dtr-types:textBlockItemType) en la ESRS 2 MDR-P, contienen información narrativa que requiere enfoques analíticos distintos de los de los datos numéricos. La clasificación de la taxonomía indica que esta información aporta contexto cualitativo y no métricas cuantificables.
Para los sistemas analíticos, esta información de la taxonomía orienta la selección de las técnicas de procesamiento adecuadas. Los supervisores pueden aprovechar herramientas modernas de análisis de texto, incluidos los grandes modelos de lenguaje, para analizar de manera sistemática la información a revelar narrativa en cuanto a consistencia, completitud y concordancia con los datos numéricos. La estructura de la taxonomía también permite que los sistemas analíticos identifiquen las relaciones entre las explicaciones narrativas y las métricas cuantitativas relacionadas, lo que apoya evaluaciones de calidad que verifican si las descripciones cualitativas de las empresas concuerdan con las cifras reportadas.
Análisis de contenido mixto
Algunos conceptos combinan información narrativa y numérica, como «Disclosure of whether internal carbon pricing schemes are applied, and if so, how these support decision making and incentivise implementation of climate-related policies and targets [text block]» (revelación de si se aplican sistemas internos de fijación del precio del carbono y, en tal caso, cómo apoyan la toma de decisiones e incentivan la aplicación de las políticas y metas relacionadas con el clima [bloque de texto]) en la ESRS E1-8. Aunque técnicamente se clasifican como bloques de texto, estas revelaciones suelen contener información numérica incrustada junto a explicaciones cualitativas, debido a su nivel en la jerarquía de los elementos del modelo de datos.
La estructura de la taxonomía ayuda a los sistemas analíticos a entender que esa información a revelar requiere enfoques de procesamiento híbridos. Los supervisores pueden diseñar capacidades analíticas que extraigan tanto los datos cuantitativos como los temas cualitativos de esta información a revelar de contenido mixto, lo que permite un análisis integral que considere tanto los aspectos numéricos como el contexto estratégico que aportan las empresas.
Datos de selección estructurada
Los conceptos de enumeración, como «High climate impact sector(s) used to determine energy intensity» (sectores de alto impacto climático usados para determinar la intensidad energética), definido como conjunto de enumeración («enum2:enumerationSetItemType») en la ESRS E1-5, ofrecen una selección estructurada entre opciones predefinidas. Este tipo de datos permite la comparación sistemática entre entidades y, a la vez, asegura la consistencia de la terminología y la categorización.
La definición de la taxonomía permite que los sistemas analíticos hagan análisis categóricos, identifiquen patrones de concentración sectorial y evalúen la consistencia entre las clasificaciones sectoriales y las métricas numéricas relacionadas. Los supervisores pueden aprovechar estos datos de selección estructurada para construir capacidades analíticas que agrupen automáticamente las entidades según características sectoriales y hagan análisis comparativos con referentes específicos de cada sector.
Datos booleanos para la evaluación de políticas
Los conceptos simples de verdadero/falso, como «Internal carbon pricing schemes are applied» (se aplican sistemas internos de fijación del precio del carbono), cuyo tipo de datos está definido como booleano (xbrli:booleanItemType) en la ESRS E1-8, ofrecen indicadores binarios claros que permiten el análisis sistemático de políticas en un gran número de entidades.
La estructura de la taxonomía permite que los sistemas analíticos identifiquen rápidamente patrones de adopción de políticas, calculen tasas de adopción por tipo de entidad o por sector y correlacionen la adopción de políticas con métricas de desempeño. Los supervisores pueden usar esta información para evaluar la efectividad de los distintos enfoques de política e identificar las entidades que podrían beneficiarse de orientación o supervisión adicional respecto a prácticas de sostenibilidad específicas.
Aprovechar las relaciones de la taxonomía para un análisis integral
La taxonomía XBRL de las ESRS define no solo conceptos individuales, sino también relaciones entre ellos que permiten referencias cruzadas y validaciones sofisticadas. Los sistemas analíticos pueden aprovechar estas relaciones para identificar inconsistencias, verificar la completitud y construir visiones integrales del desempeño de la entidad que abarquen varias áreas de información a revelar.
Para los supervisores, esta información sobre relaciones permite enfoques analíticos que consideran el desempeño de manera holística, en lugar de examinar métricas individuales de forma aislada. La estructura de la taxonomía soporta sistemas analíticos capaces de identificar automáticamente las conexiones entre distintos aspectos del desempeño en sostenibilidad y señalar las situaciones en que distintas áreas de información a revelar aportan información contradictoria.
Soporte a distintos casos de uso analíticos
La naturaleza estructurada de la taxonomía XBRL de las ESRS permite que los sistemas analíticos soporten varios casos de uso de supervisión de manera simultánea. Los supervisores que hacen evaluaciones detalladas de entidades pueden aprovechar los datos granulares y la información sobre relaciones, mientras que quienes hacen análisis de todo un sector pueden usar la estructura estandarizada para agregar y comparar la información de varias entidades.
La taxonomía también soporta tanto el análisis cuantitativo de los datos numéricos como el análisis cualitativo del contenido narrativo dentro de un marco unificado. Esta integración permite enfoques analíticos integrales que consideran todos los aspectos del reporte de la entidad, en lugar de concentrarse solo en las métricas cuantificables.
Este ejemplo práctico muestra cómo comprender y aprovechar la estructura de la taxonomía XBRL transforma las capacidades de los sistemas analíticos: de simples herramientas de presentación de datos pasan a ser plataformas sofisticadas de análisis regulatorio, capaces de apoyar actividades complejas de supervisión y de formulación de políticas.
Caso de estudio: aprovechamiento de la taxonomía XBRL de Solvencia II para evaluar el riesgo de sostenibilidad en la supervisión prudencial
La aplicación de la inteligencia de las taxonomías XBRL va más allá de los marcos de información a revelar al público y abarca los sistemas de reporte de supervisión diseñados para la vigilancia prudencial y la evaluación de la estabilidad financiera. La taxonomía XBRL de Solvencia II (Solvency II) de la EIOPA, desarrollada bajo la arquitectura Data Point Model (DPM, modelo de puntos de datos), muestra cómo las autoridades de supervisión pueden aprovechar la información estructurada de la taxonomía para mejorar su evaluación de los riesgos de sostenibilidad en la supervisión de seguros.
Arquitectura DPM y requisitos analíticos de la supervisión
La arquitectura Data Point Model en la que se basa la taxonomía de Solvencia II refleja los requisitos específicos de la supervisión prudencial, en la que los supervisores necesitan datos precisos y comparables para evaluar la solidez financiera y el riesgo sistémico. A diferencia de los marcos de información a revelar al público, que atienden a varios grupos de interés, las taxonomías de supervisión se centran específicamente en dar a los supervisores la información necesaria para cumplir sus responsabilidades de vigilancia prudencial.
Esta diferencia de arquitectura tiene implicaciones importantes para el diseño de los sistemas analíticos. Los sistemas analíticos de supervisión deben dar prioridad a la precisión, la consistencia y la integración con los marcos existentes de evaluación prudencial, más que a la accesibilidad para los grupos de interés en general. La estructura de la taxonomía permite que los sistemas analíticos mantengan estándares estrictos de calidad de datos y, a la vez, soporten los cálculos complejos y las evaluaciones de riesgo que requiere la supervisión prudencial. Un ejemplo de ello es la inclusión de la información a revelar ASG del Pilar 3 en el marco de reporte DPM de la EBA, DPM v3.3 fase 3. La integración de la información a revelar ASG del Pilar 3 en el DPM y la taxonomía de la EBA exigió consistencia en el modelado de datos, por ejemplo, reutilizar elementos ya existentes de la taxonomía cuando fuera posible y crear elementos nuevos acordes con los principios existentes de la taxonomía. Un ejemplo de este tipo de taxonomía es la taxonomía XBRL de la EBA.
Evaluación de la exposición al riesgo climático mediante datos estructurados
La taxonomía XBRL de la EIOPA incluye conceptos para reportar los valores monetarios de los activos expuestos al riesgo de transición relacionado con el cambio climático y al riesgo físico relacionado con el cambio climático, tal como se recogen en la plantilla S.06.04. Estos datos permiten a los supervisores evaluar de manera sistemática cómo los riesgos relacionados con el clima podrían afectar la situación financiera de las empresas de seguros y la estabilidad del sector asegurador en general.
Para los sistemas analíticos, la estructura de la taxonomía aporta un contexto esencial sobre cómo deben interpretarse y agregarse estas mediciones de exposición. Los supervisores pueden aprovechar esta información para construir capacidades analíticas que calculen automáticamente las concentraciones de exposición de todo el sector, identifiquen instituciones atípicas con perfiles de riesgo inusuales y evalúen si las exposiciones reportadas concuerdan con las condiciones generales del mercado y con las expectativas regulatorias.
La definición del tipo de datos monetario asegura que los sistemas analíticos apliquen un manejo de monedas y métodos de agregación consistentes, lo que permite comparaciones significativas entre instituciones y a lo largo del tiempo. La estructura de la plantilla también permite que los sistemas analíticos entiendan las relaciones entre los distintos tipos de exposición climática, lo que apoya evaluaciones de riesgo integrales que consideran tanto los riesgos climáticos de transición como los físicos dentro de marcos analíticos integrados.
Análisis de los requisitos de capital por la mitigación del riesgo
Los conceptos sobre el capital de solvencia obligatorio por los efectos de la mitigación del riesgo en distintos tipos de riesgo de catástrofe, reportados en la plantilla S.27.01, dan a los supervisores información detallada sobre cómo calculan las instituciones sus requisitos de capital y en qué medida dependen de técnicas de mitigación del riesgo.
La estructura de la taxonomía permite que los sistemas analíticos entiendan la relación entre los requisitos de capital brutos y los efectos de la mitigación del riesgo, lo que apoya las evaluaciones de supervisión sobre si las instituciones calculan adecuadamente su posición de capital. Los supervisores pueden aprovechar esta información estructurada para construir capacidades analíticas que verifiquen automáticamente la consistencia de los cálculos, identifiquen instituciones con patrones inusuales de mitigación del riesgo y evalúen la efectividad agregada de las técnicas de mitigación del riesgo en el sector asegurador.
Esta información resulta particularmente valiosa para la supervisión relacionada con la sostenibilidad, porque muchos riesgos de catástrofe reflejan cada vez más factores ambientales, como fenómenos meteorológicos extremos o desastres naturales que pueden verse intensificados por el cambio climático. La estructura de la taxonomía permite que los sistemas analíticos conecten la evaluación tradicional del riesgo de catástrofe con un seguimiento más amplio del riesgo de sostenibilidad.
Evaluación de la integración de la sostenibilidad en los productos
La taxonomía XBRL de Solvencia II incluye conceptos para analizar cómo los productos de seguros integran medidas de prevención del riesgo, incluido el monto total de las primas emitidas brutas de los productos en los que se tienen en cuenta medidas de prevención del riesgo, tal como se recoge en la plantilla S.14.02. Esta información permite a los supervisores evaluar en qué medida las empresas de seguros incorporan consideraciones de sostenibilidad en el diseño y la tarifación de sus productos.
Para los sistemas analíticos, la estructura de la taxonomía ofrece el marco necesario para calcular métricas significativas sobre la integración de la sostenibilidad en cada producto. Los supervisores pueden aprovechar esta información para construir capacidades analíticas que evalúen qué proporción del negocio de una institución incorpora medidas de prevención del riesgo, comparen la integración de la sostenibilidad en los productos de distintas instituciones e identifiquen tendencias en la forma en que el sector asegurador incorpora consideraciones de sostenibilidad en sus actividades centrales.
El uso de un tipo de datos monetario para el concepto «gross written premium» (primas emitidas brutas) asegura que los sistemas analíticos puedan hacer agregaciones y comparaciones adecuadas que reflejen la escala y la importancia de los productos que integran la sostenibilidad dentro del portafolio total de negocios de las instituciones.
Análisis del diseño de las pólizas mediante indicadores booleanos
Los conceptos booleanos que indican si el diseño del producto tiene en cuenta medidas de prevención del riesgo, recogidos también en la plantilla S.14.02, dan a los supervisores indicadores binarios claros que permiten la evaluación sistemática de los enfoques de las pólizas en un gran número de instituciones y productos.
La estructura de la taxonomía permite que los sistemas analíticos calculen rápidamente las tasas de adopción de medidas de prevención del riesgo, identifiquen las instituciones rezagadas frente a las prácticas del sector y correlacionen los enfoques de diseño de las pólizas con otras métricas relacionadas con la sostenibilidad. Los supervisores pueden aprovechar esta información estructurada para evaluar la efectividad de la orientación regulatoria sobre la integración de la sostenibilidad e identificar las áreas en que podría necesitarse más atención de supervisión.
El tipo de datos booleano también soporta los sistemas analíticos que necesitan hacer análisis categóricos, lo que permite a los supervisores agrupar las instituciones según sus enfoques de integración de la sostenibilidad y evaluar si las distintas estrategias de diseño de las pólizas se correlacionan con distintos perfiles de riesgo o patrones de desempeño financiero.
Soporte a una evaluación prudencial integral de la sostenibilidad
La integración de estos distintos tipos de datos dentro de la taxonomía XBRL de Solvencia II permite que los sistemas analíticos soporten una evaluación integral de la sostenibilidad que abarca la exposición de los activos, la suficiencia de capital, el diseño de productos y la implementación de políticas. Los supervisores pueden aprovechar la estructura de la taxonomía para construir capacidades analíticas que examinen las consideraciones de sostenibilidad de manera holística, en lugar de tratarlas como requisitos de reporte aislados.
Este enfoque integral resulta esencial para una supervisión prudencial efectiva, porque los riesgos de sostenibilidad suelen manifestarse mediante interacciones complejas entre distintos aspectos del negocio asegurador. Las exposiciones de los activos relacionadas con el clima podrían interactuar con las decisiones de diseño de productos y con las evaluaciones de suficiencia de capital de maneras que requieren enfoques analíticos integrados para comprenderlas por completo.
Mayor eficiencia de la supervisión mediante el análisis estructurado
La naturaleza estructurada de la taxonomía XBRL de Solvencia II permite que los sistemas analíticos automaticen muchos aspectos de la evaluación de supervisión relacionada con la sostenibilidad, manteniendo la precisión y la confiabilidad que exige la supervisión prudencial. Los supervisores pueden aprovechar la estructura de la taxonomía para construir capacidades analíticas que señalen automáticamente patrones inusuales, verifiquen la consistencia de los cálculos e identifiquen las instituciones que requieren atención de supervisión adicional.
Esta automatización permite que los recursos de supervisión se concentren en el análisis y el juicio, en lugar de la compilación de datos y la evaluación básica de calidad. La estructura de la taxonomía también soporta sistemas analíticos que pueden dar a los supervisores evaluaciones integrales del riesgo de sostenibilidad que se integran sin tropiezos con los procesos más amplios de supervisión prudencial.
El ejemplo de Solvencia II muestra cómo la inteligencia de las taxonomías XBRL puede mejorar las capacidades analíticas de la supervisión, manteniendo los requisitos de precisión y confiabilidad que exige la vigilancia prudencial. Comprender estas aplicaciones se vuelve esencial para las autoridades de supervisión que buscan integrar de manera efectiva las consideraciones de sostenibilidad en sus procesos centrales de supervisión.
Retos analíticos cuando los datos carecen de una implementación estructurada
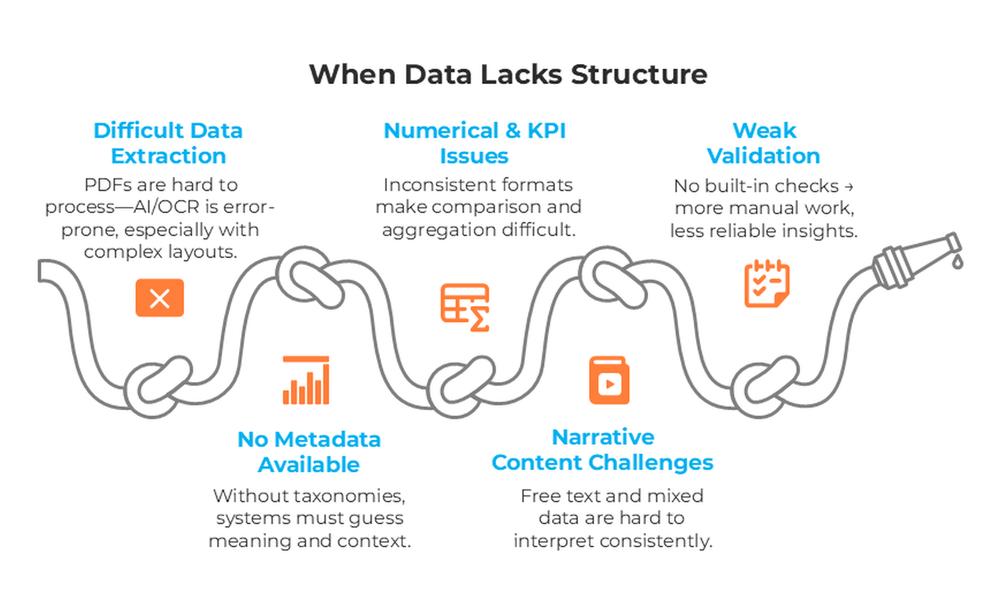
La ausencia de formatos de datos estructurados para ciertos requisitos de información a revelar crea retos analíticos considerables para los supervisores y reguladores. El Reglamento sobre la divulgación de información relativa a la sostenibilidad en el sector de los servicios financieros (Sustainable Finance Disclosure Regulation, SFDR) es un ejemplo de estas dificultades, ya que exige una información a revelar completa sobre sostenibilidad, pero requiere su publicación en formatos legibles por humanos, como documentos PDF, y no como datos estructurados legibles por máquinas. Este enfoque, si bien asegura la accesibilidad para los lectores humanos, puede crear obstáculos importantes para el análisis sistemático de los datos y la vigilancia regulatoria.
Retos de extracción de datos de documentos no estructurados
Cuando las instituciones financieras publican su información a revelar como documentos PDF creados a partir de plantillas de procesador de texto, los supervisores enfrentan de inmediato retos técnicos para extraer datos utilizables. A diferencia de los reportes XBRL estructurados, en los que los datos están claramente marcados con metadatos, los documentos PDF presentan la información en formatos diseñados para el consumo humano y no para el procesamiento automatizado.
La tecnología de reconocimiento óptico de caracteres (OCR) puede convertir el texto de un PDF a un formato legible por máquinas, pero este proceso introduce múltiples fuentes potenciales de error y ambigüedad. La exactitud del OCR depende en gran medida de la calidad del documento, de las fuentes tipográficas elegidas y de la complejidad del diseño. Aunque los mecanismos de extracción de datos de documentos PDF mejoran constantemente, pueden tener dificultades con las tablas dentro de estos documentos. En particular, mantener las relaciones entre los encabezados de columna y los valores de los datos constituye un reto, lo que puede desalinear información crítica.
Las capacidades modernas de IA, incluidos los grandes modelos de lenguaje, ofrecen enfoques más sofisticados para extraer información de documentos no estructurados. Estos sistemas pueden identificar y extraer datos específicos aun cuando aparecen en formatos o ubicaciones variadas dentro de los documentos. Sin embargo, la extracción basada en IA introduce retos distintos, como posibles errores de interpretación, extracciones inconsistentes entre documentos similares y la dificultad de verificar la exactitud de la información extraída sin una revisión manual.
Complejidad de los sistemas analíticos sin metadatos estructurados
La ausencia de datos y metadatos estructurados cambia de fondo la forma en que deben diseñarse y operarse los sistemas analíticos. Cuando trabajan con la información a revelar en PDF del SFDR, los usuarios de los datos no pueden apoyarse en taxonomías predefinidas que especifiquen el significado de los datos, sus relaciones y sus reglas de validación. En su lugar, los sistemas analíticos deben incorporar una lógica de interpretación compleja para entender qué representan los datos extraídos y cómo se relacionan entre sí las distintas piezas de información.
La información que en los datos basados en XBRL se define en la taxonomía en forma de metadatos (por ejemplo, los tipos de datos de los elementos, las referencias a actos jurídicos, las etiquetas de documentación o las relaciones entre elementos) debe programarse de forma fija (hardcoded) en el sistema cuando los datos se recolectan en PDF o en otros formatos de datos no estructurados.
Incluso afirmaciones de verdadero/falso aparentemente simples, como «¿Tiene este producto financiero un objetivo de inversión sostenible?», se vuelven analíticamente complejas en formatos no estructurados. Aunque la respuesta pueda parecer sencilla, los sistemas analíticos deben verificar que han identificado correctamente la pregunta pertinente y la respuesta asociada, en particular cuando los documentos contienen varias preguntas similares o cuando las instituciones dan respuestas matizadas que incluyen texto explicativo.
Retos para identificar los datos numéricos
Considere el reto de analizar datos numéricos como «Investee countries subject to social violations» (países receptores de la inversión sujetos a infracciones sociales). En un sistema estructurado, este dato estaría claramente marcado con metadatos que indicarían su significado, sus unidades y su metodología de cálculo. En formato PDF, los sistemas analíticos deben primero ubicar esta información dentro de diseños de documento potencialmente variables, extraer el valor numérico asociado y luego inferir su significado a partir del contexto que lo rodea.
El proceso de extracción se vuelve particularmente complejo cuando los documentos usan enfoques de formato, abreviaturas o estilos de presentación diferentes. Una institución podría presentar esta información en una tabla claramente rotulada, mientras que otra podría incluirla dentro de un texto narrativo. Los sistemas analíticos deben adaptarse a esta variabilidad y, a la vez, mantener la consistencia en la forma en que interpretan y clasifican la información extraída. Cuando la información se expresa en valores monetarios, los mecanismos de extracción de datos deben asegurar que los valores y sus definiciones de moneda correspondientes se procesen juntos.
Complicaciones del análisis de KPI
Los indicadores clave de desempeño, como «Scope 1 GHG emissions» (emisiones de GEI de alcance 1) o «Board gender diversity» (diversidad de género en la junta directiva), plantean retos analíticos adicionales cuando se revelan en formatos no estructurados. Estas métricas requieren no solo una extracción numérica exacta, sino también comprender las unidades, el alcance y la metodología de cálculo usados. Sin metadatos estructurados, los sistemas analíticos no pueden verificar automáticamente si las distintas instituciones usan enfoques de medición o límites de reporte consistentes.
La falta de información dimensional estructurada significa que los sistemas analíticos no pueden agregar ni comparar fácilmente los KPI de varias instituciones. Con la información a revelar en PDF, esta información de contexto debe extraerse de descripciones narrativas que pueden ser incompletas o inconsistentes entre las distintas instituciones.
Dificultades para procesar el contenido narrativo
La información a revelar narrativa, como «Description of policies to identify and prioritise principal adverse impacts on sustainability factors» (descripción de las políticas para identificar y priorizar las principales incidencias adversas sobre los factores de sostenibilidad), requiere capacidades sofisticadas de análisis de texto para extraer conocimientos significativos. A diferencia de los bloques de texto estructurados, que incluyen marcas semánticas claras, estas secciones narrativas aparecen como texto libre que puede variar de manera significativa en estructura, nivel de detalle y terminología entre las distintas instituciones.
Los sistemas analíticos deben emplear técnicas de procesamiento de lenguaje natural para identificar los temas clave, los elementos de política y los enfoques de implementación dentro de estas narrativas. Sin embargo, la ausencia de un marcado semántico estructurado significa que el análisis automatizado no puede distinguir fácilmente entre las descripciones sustantivas de las políticas y el lenguaje genérico de cumplimiento, ni entre los compromisos específicos y las declaraciones de aspiración.
Problemas del análisis de contenido mixto
El contenido que combina información narrativa y numérica, como las respuestas a «¿Cuál es la proporción mínima de inversiones en actividades de transición y facilitadoras?», crea retos analíticos especialmente complejos. Esta información a revelar puede incluir porcentajes, montos absolutos, metodologías de cálculo y explicaciones cualitativas dentro de un mismo bloque de texto.
Los sistemas analíticos deben extraer varios tipos de información de estas secciones de contenido mixto, manteniendo las relaciones entre los distintos elementos. La ausencia de un marcado estructurado significa que los sistemas no pueden distinguir fácilmente entre los datos de desempeño histórico, los compromisos futuros y los escenarios hipotéticos que podrían aparecer en la misma sección de información a revelar.
Dificultades de aseguramiento de la calidad y de validación
La ausencia de reglas de validación estructuradas significa que los sistemas analíticos no pueden verificar automáticamente la consistencia ni la completitud de los datos extraídos. En los sistemas de reporte estructurado, las reglas de validación incorporadas pueden señalar inconsistencias matemáticas, información a revelar obligatoria faltante o relaciones de datos inadecuadas.
Con datos no estructurados, desarrollar capacidades equivalentes de aseguramiento de la calidad exige crear una lógica de validación a la medida capaz de adaptarse a la variabilidad inherente a los formatos de documento de texto libre. El proceso de aseguramiento de la calidad puede requerir la participación de personas para verificar los resultados de las comprobaciones de inconsistencias y decidir cómo proceder con los errores encontrados.
Limitaciones del análisis comparativo
Quizá lo más importante es que la falta de datos estructurados limita gravemente la capacidad de los usuarios de los datos para hacer análisis comparativos sistemáticos entre varias instituciones y/o productos. Sin una organización de los datos y un marcado semántico consistentes, los sistemas analíticos no pueden identificar fácilmente métricas comparables, agregar tendencias sectoriales ni comparar el desempeño de una institución con el de sus pares.
Estas limitaciones analíticas restringen de fondo las capacidades de los usuarios de los datos, pues dificultan identificar riesgos emergentes, evaluar los patrones de cumplimiento en todo el sector o formular respuestas de política basadas en evidencia. El contraste con los enfoques de reporte estructurado muestra cuánto afectan las decisiones sobre el formato de los datos a las capacidades analíticas.
Comprender estos retos se vuelve esencial para las autoridades regulatorias que evalúan enfoques de implementación para nuevos requisitos de información a revelar sobre sostenibilidad, y para valorar los costos y beneficios de los mandatos de reporte estructurado frente a los no estructurados.
Resumen
Construir sistemas analíticos efectivos exige un enfoque sistemático que ajuste las capacidades técnicas a las características de los datos y a los requisitos de los usuarios. La base empieza por establecer objetivos analíticos claros, alineados con los mandatos institucionales, y por comprender las diversas necesidades de los usuarios en los distintos niveles de la organización.
Las características de formato de los datos determinan de fondo las posibilidades analíticas. Los datos estructurados con metadatos ricos, en particular la información en formato XBRL, permiten capacidades analíticas sofisticadas, como la validación automatizada, el análisis dimensional y la conservación de las relaciones semánticas. Las herramientas tradicionales de inteligencia de negocios funcionan bien con datos numéricos estructurados, mientras que el contenido narrativo requiere enfoques modernos basados en IA para su análisis sistemático.
Las taxonomías XBRL ofrecen oportunidades analíticas excepcionales cuando se aprovechan adecuadamente. Los elementos estructurales, como las relaciones de presentación, los linkbases de definición, las capacidades dimensionales y las definiciones de tipos de datos, permiten sistemas analíticos que conservan el significado semántico en lugar de tratar a XBRL como simples datos numéricos. Las aplicaciones prácticas en marcos como la información a revelar sobre sostenibilidad y en sistemas de reporte de supervisión como Solvencia II muestran cómo la inteligencia de las taxonomías mejora las capacidades de análisis regulatorio.
El contraste con los formatos no estructurados revela limitaciones analíticas importantes. La información a revelar en PDF crea retos considerables para la extracción de datos, el aseguramiento de la calidad y el análisis comparativo. Estas limitaciones restringen de fondo las capacidades de supervisión y resaltan la importancia de los formatos de datos estructurados para una vigilancia regulatoria efectiva.
Los sistemas analíticos exitosos a menudo requieren estrategias de integración que combinen varias fuentes de datos y enfoques de procesamiento, manteniendo la consistencia y la calidad. La elección entre la inteligencia de negocios tradicional y las soluciones basadas en IA depende del equilibrio entre el contenido numérico y el narrativo, y de la complejidad de los requisitos analíticos.
Comprender estos principios permite que los reguladores y los participantes del mercado diseñen capacidades analíticas que apoyen de manera efectiva los objetivos de vigilancia, adaptándose a las diversas características de la información en los distintos marcos de reporte y enfoques de implementación.
Texto original en inglés: https://playbook.xbrl.org/