Inicio › Capítulos › Capítulo 6 · Recolección, almacenamiento y análisis de datos
6.1–6.2 · Recepción y visualización de reportes XBRL
13 min de lectura
Juan Carlos Rodríguez R. participó en la elaboración del contenido original de esta sección como desarrollador de contenido de XBRL International. La versión final en inglés es la publicada por XBRL International.
6 · Recolección, almacenamiento y análisis de datos
6.1 · Visión general
Esta sección ofrece una comprensión del proceso de intercambio de datos y cubre aspectos como la recolección, la validación, el almacenamiento, la seguridad, la visualización y la escalabilidad de los datos. Además, el curso explorará cómo las tecnologías emergentes, incluidas las soluciones en la nube, pueden optimizar el reporte XBRL para el seguimiento y el análisis.
Objetivos de aprendizaje
Al terminar esta sección, los lectores podrán:
- Conocer el proceso de recolección, validación y envío de los datos.
- Identificar métodos de recolección y de validación.
- Comprender técnicas de visualización para el análisis.
- Conocer las medidas de seguridad para la información a revelar (divulgación) en formato digital.
- Comprender cómo desarrollar tableros (dashboards) para el análisis regulatorio.
- Comprender la escalabilidad de los sistemas de reporte.
- Desarrollar estrategias para gestionar las correcciones de los reportes.
6.2 · Recepción y visualización de reportes XBRL
Objetivos de aprendizaje
- Comprender el proceso completo de intercambio de datos, desde la recolección hasta el análisis.
- Identificar los distintos mecanismos para recibir reportes XBRL.
- Reconocer la importancia de la validación, el envío y el almacenamiento para asegurar la calidad de los datos.
- Conocer mecanismos para visualizar (renderizar) los reportes publicados de modo que las personas puedan leerlos.
Introducción
Un intercambio de datos eficiente es crucial para el reporte regulatorio, pues asegura que la información estructurada fluya sin tropiezos entre los preparadores de la información, los supervisores y los grupos de interés. Esta sección explora el proceso completo de intercambio de datos.
Los supervisores usan distintos mecanismos para recibir los reportes XBRL, cada uno con distintos niveles de automatización y control. Una vez recibidos, estos reportes deben validarse para asegurar que cumplen las reglas definidas, antes de almacenarlos y analizarlos.
Otro aspecto crítico del proceso de intercambio de datos es la visualización (renderizado) de los reportes XBRL para que las personas puedan interpretarlos, de modo que los reportes estructurados se muestren en un formato legible por humanos.
El proceso de recolección de datos
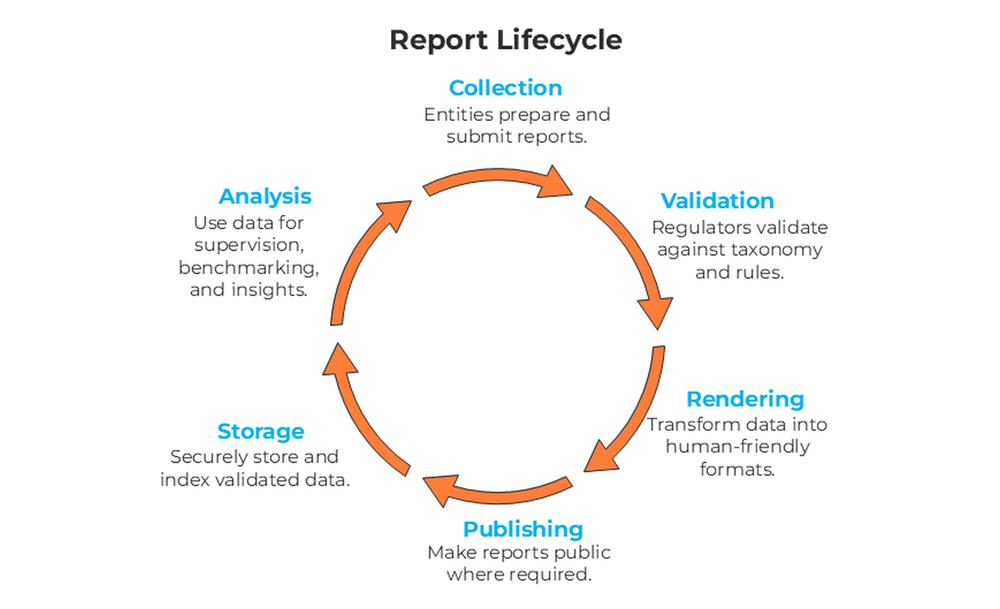
El proceso de reporte en un entorno XBRL comienza mucho antes de que se envíe un archivo. Empieza con una necesidad regulatoria: la definición de qué información se requiere, con qué frecuencia debe reportarse y la decisión de usar XBRL como estándar para la recolección y validación de los datos. A partir de ahí, una serie de acciones coordinadas entre los supervisores y las entidades que reportan asegura que los datos no solo se intercambien, sino que tengan sentido, estén validados y queden listos para su uso. Una vez establecidas estas bases, el proceso de reporte pasa a la fase operativa. El proceso de recolección de datos tiene tres etapas principales: recepción y validación; visualización y publicación; y, por último, almacenamiento y análisis.
Recepción y validación
Este proceso corresponde al intercambio formal de datos entre la entidad que reporta y el supervisor. Desde la perspectiva del preparador, implica reunir los datos requeridos, generar un documento XBRL y enviarlo por el canal designado. Desde el lado del supervisor, se refiere a la recepción de esos reportes mediante plataformas de envío.
Una vez enviado un reporte, debe validarse para confirmar que cumple la especificación técnica XBRL, la definición de la taxonomía y las reglas propias del supervisor. La validación automatizada impide el ingreso de reportes estructuralmente incorrectos o inconsistentes y asegura que los datos recibidos sean confiables y completos antes de su almacenamiento y análisis.
Visualización y publicación
Como los reportes XBRL están pensados principalmente para ser leídos por máquinas, los datos que contienen también deben estar disponibles en un formato fácil de entender para las personas. Los usuarios pueden ser funcionarios internos o, cuando los reportes se ponen a disposición del público, el público en general. El enfoque de visualización que se adopte dependerá del formato de los reportes. La ley puede exigir a quienes recogen los datos que publiquen la información que reciben, ya sea completa o en una forma determinada. En esos casos, quien recoge los datos debe asegurar que estén disponibles para el público o para un grupo definido de grupos de interés, de acuerdo con los requisitos legales y regulatorios.
Almacenamiento y análisis
Los reportes que superan el proceso de validación automatizada se almacenan luego en bases de datos o repositorios seguros. En esta etapa, la información pasa a formar parte del lago de datos (data lake) o de la bodega de datos (data warehouse) regulatoria, donde se indexa y se vincula con metadatos (p. ej., fecha de envío, identificador de la entidad, periodo de reporte). Este almacenamiento centralizado asegura la trazabilidad de largo plazo y soporta futuras auditorías o necesidades de reprocesamiento. En muchos sistemas regulatorios, esta fase también incluye protocolos de archivo digital y de copias de respaldo.
La etapa final consiste en usar los datos estructurados con fines regulatorios, de supervisión o de política pública. Como los reportes XBRL están estandarizados y validados, pueden consultarse, agregarse y compararse entre entidades y periodos, lo que hace posibles los sistemas de alerta temprana, el análisis de riesgos, la comparación con pares (benchmarking) y la toma de decisiones informada. En esta etapa también pueden aplicarse analítica avanzada o herramientas de IA para obtener más conocimiento de los datos.
Lea más sobre los enfoques para almacenar y analizar datos en este artículo.
Recepción de reportes XBRL
Los reportes XBRL pueden recibirse mediante distintos mecanismos, según el entorno regulatorio, la infraestructura técnica y el nivel de madurez de las entidades que reportan. Cada enfoque equilibra la facilidad de uso, la escalabilidad y el control.
Cargue por portal
El envío manual a través de un portal web seguro es uno de los puntos de partida más comunes para la recepción de reportes XBRL. En este modelo, la entidad que reporta inicia sesión en una plataforma oficial, selecciona el formulario de reporte o la taxonomía correspondiente y carga el reporte XBRL respectivo.
Envío por API
En entornos más avanzados, los supervisores ofrecen canales automatizados de envío mediante interfaces de programación de aplicaciones (Application Programming Interfaces, API). Este método permite a las entidades que reportan integrar sus sistemas internos directamente con la infraestructura del supervisor, lo que hace posible una transferencia de datos fluida, en tiempo real y de alto volumen. Reduce la intervención humana y el riesgo de errores manuales, y mejora de forma importante la escalabilidad y la velocidad.
Enfoques híbridos
Muchos supervisores adoptan un modelo híbrido que combina métodos manuales y automatizados. Este enfoque da flexibilidad: permite a las entidades más avanzadas automatizar sus procesos por medio de API y, al mismo tiempo, mantiene una opción manual para las organizaciones más pequeñas o con menos capacidad técnica.
Un modelo híbrido también facilita una transformación digital gradual, pues permite a los supervisores vincular a una amplia variedad de preparadores sin excluir a quienes todavía están en etapas tempranas de desarrollo de sus sistemas.
Autenticación y verificaciones iniciales
Sin importar el enfoque elegido, es esencial aplicar mecanismos de autenticación robustos que aseguren un acceso seguro y envíos trazables. Según la política de seguridad de la organización, esto puede implicar credenciales, certificados digitales o protocolos de autenticación multifactor.
El portal de recepción es el punto de entrada a la plataforma de procesamiento. Las verificaciones automáticas en la puerta de entrada, en el momento de cargar el archivo, ayudan a que solo avancen archivos seguros y válidos, lo que reduce el riesgo y agiliza el procesamiento. Entre las verificaciones comunes están:
- Verificación de software malicioso (malware): analiza los archivos para impedir que entre contenido malicioso a la plataforma o al sistema en general.
- Verificación de formato: comprueba que los tipos de archivo correspondan a los formatos que admite la plataforma.
- Cumplimiento de la taxonomía: confirma que los archivos XBRL enviados usen la versión de la taxonomía correcta para el periodo de reporte, lo que permite rechazar a tiempo los reportes inválidos.
Asegurar la calidad de los datos y el cumplimiento
Para asegurar que los datos enviados sean exactos, completos y aptos para fines regulatorios, los mecanismos de validación deben aplicarse de forma sistemática. Estos mecanismos evalúan si los reportes cumplen tanto los requisitos técnicos de la especificación XBRL como las expectativas específicas definidas por el supervisor.
La validación puede ocurrir en distintos momentos del ciclo de vida del reporte, y cada uno cumple un papel propio en la protección de la calidad de los datos.
Validación antes del envío frente a validación después del envío
La validación antes del envío ocurre del lado del preparador. Permite a las entidades revisar errores estructurales o lógicos antes de enviar formalmente el reporte, lo que ayuda a evitar rechazos y retrasos.
La validación después del envío la realiza el supervisor una vez recibido el reporte. Este paso funciona como una segunda capa de control y asegura que no entren al sistema datos defectuosos o que no cumplan, aun si los preparadores omitieron las herramientas de validación o las usaron mal.
Ambas capas contribuyen a un marco sólido de calidad de los datos, en particular cuando están alineadas con conjuntos de reglas claramente documentados.
El propio estándar XBRL incluye mecanismos de validación incorporados, como las verificaciones de consistencia con el esquema y las verificaciones dimensionales. Además, la taxonomía puede definir lógica de validación de negocio —como reglas de cálculo o verificaciones cruzadas entre datos— mediante reglas XBRL Formula. Por encima de eso, la plataforma de recepción del supervisor normalmente aplica reglas de reporte (filing rules) que determinan cómo y cuándo pueden enviarse los reportes, incluidas condiciones sobre los periodos aceptados, las convenciones de nombres y la información a revelar obligatoria.
Lea más sobre la validación de reportes XBRL en este artículo.
Visualización (renderizado) de reportes XBRL
Los reportes XBRL están diseñados principalmente para máquinas. Aunque ofrecen un formato muy estructurado, ideal para la validación y el análisis, los datos en bruto de un reporte XBRL no son fáciles de interpretar para las personas. Mientras que las máquinas están optimizadas para procesar datos estructurados, las personas dependen de señales visuales como tablas, etiquetas, jerarquías y resúmenes para entender los reportes. La visualización permite presentar los hechos estructurados en una disposición intuitiva sin alterar la integridad de los datos subyacentes. De ahí surge la necesidad de vistas legibles por humanos que hagan la información accesible para los preparadores, los supervisores, los auditores y el público.
Distintas herramientas soportan el proceso de visualización, según la etapa y el uso previsto. Normalmente se agrupan en tres categorías principales. La primera incluye los visores integrados en los portales de supervisión, que ofrecen una visualización web directamente a partir de los datos recibidos y permiten a los usuarios navegar, buscar y revisar los reportes en línea. La segunda categoría comprende las herramientas de visualización específicas de XBRL, que interpretan las estructuras de la taxonomía y aplican plantillas de reporte para generar vistas de los reportes XBRL legibles por humanos.
En muchos casos, las herramientas de visualización ofrecen funciones adicionales como anotaciones, filtros, vistas comparativas y opciones de exportación, que mejoran la facilidad de uso y facilitan la comunicación entre áreas. La elección del enfoque de visualización de los reportes XBRL depende del formato del reporte recibido.
Visualización de iXBRL
Inline XBRL (iXBRL) es un formato que combina datos estructurados y HTML legible por humanos en un solo archivo. Permite que un mismo documento sea legible por máquinas y, a la vez, se pueda abrir directamente en un navegador web.
Para que los datos XBRL de los reportes Inline XBRL sean más accesibles para los usuarios, se recomienda a quienes recogen los reportes ponerlos a disposición en un software visor de Inline XBRL en línea, además de ofrecer enlaces de descarga al Report Package recibido. Quienes recogen los reportes también pueden considerar ofrecer funciones interactivas adicionales para buscar y analizar los datos de los reportes Inline XBRL.
Visualización con plantillas de reporte
En los entornos donde los reportes XBRL se reciben como xBRL-XML, xBRL-JSON o xBRL-CSV, la visualización puede lograrse mediante plantillas de reporte predefinidas que entrega el supervisor. Las plantillas de reporte XBRL (XBRL Reporting Templates, Table Linkbase) ofrecen una forma estándar para que los autores de la taxonomía definan estructuras de tabla amigables para los usuarios de negocio con las cuales visualizar los reportes XBRL. El Table Linkbase es más adecuado para un entorno de reporte cerrado, donde los reportes XBRL pueden visualizarse en una plantilla estándar. Estas plantillas definen cómo deben organizarse, agruparse y etiquetarse los hechos reportados para que las personas los consulten.
Otros enfoques
Las herramientas de visualización pueden usar los linkbases de presentación y de etiquetas de la taxonomía para organizar los datos en tablas o formularios legibles, que a menudo reproducen la estructura de los reportes en papel o en hojas de cálculo. Este enfoque permite a los supervisores presentar los datos en formatos conocidos y, al mismo tiempo, mantener la coherencia con la taxonomía subyacente.
Las plataformas de inteligencia de negocios (Business Intelligence, BI) y de visualización de datos consumen los datos XBRL validados —con frecuencia después de transformarlos— y presentan tableros, gráficos o tablas resumen para el análisis interno y la toma de decisiones. Estas herramientas son especialmente útiles para las funciones de supervisión y análisis una vez que los datos se han integrado en las bodegas de datos.
Publicación de los reportes
Algunas entidades que recogen datos deciden poner a disposición del público los reportes XBRL o Inline XBRL recibidos. Al hacerlo, es esencial que los reportes se publiquen exactamente como los enviaron las entidades que reportan, sin ninguna modificación. Cuando los reportes se reciben como Report Packages, deberían publicarse en ese mismo formato para mantener la coherencia y facilitar su uso de principio a fin. Para mejorar la accesibilidad, se anima a quienes recogen los datos a ofrecer API que permitan a las herramientas automatizadas obtener, analizar e integrar los datos XBRL de manera programática. Publicar los reportes en xBRL-JSON —junto con formatos como Inline XBRL o además de ellos— puede mejorar aún más su utilidad, ya que ofrece una estructura amigable para los desarrolladores y más fácil de adoptar. Por último, quienes recogen los datos también pueden publicar vistas visualizadas de los reportes XBRL para facilitar su lectura por personas, como se explicó en el apartado anterior.
Lea más sobre la recolección y el procesamiento de datos en la guía de XBRL International.
Resumen
Los supervisores deben establecer un proceso claro y completo para recibir los reportes XBRL: definir los requisitos de datos, permitir el envío seguro mediante portales o API, y validar los reportes frente a las reglas técnicas y de negocio para asegurar la calidad de los datos. La autenticación robusta, las verificaciones en la puerta de entrada y los métodos de envío flexibles (manual, automatizado o híbrido) son clave para atender a entidades que reportan muy diversas. Una vez validados y almacenados los datos, se necesitan mecanismos de visualización para que los datos XBRL estructurados sean legibles por humanos, con herramientas como visores de Inline XBRL, plantillas de reporte o tableros de BI. La elección del enfoque de visualización debería ajustarse al formato de los reportes recibidos y a las necesidades de los usuarios internos y externos. Cuando los reportes se publican, deberían compartirse exactamente como se enviaron, idealmente con API y con versiones en xBRL-JSON, para maximizar la accesibilidad, la automatización y la facilidad de uso tanto para usuarios técnicos como no técnicos.
Texto original en inglés: https://playbook.xbrl.org/