Inicio › Capítulos › Capítulo 5 · Aspectos técnicos de XBRL
5.1–5.2 · Componentes de una taxonomía XBRL
29 min de lectura
Juan Carlos Rodríguez R. participó en la elaboración del contenido original de esta sección como desarrollador de contenido de XBRL International. La versión final en inglés es la publicada por XBRL International.
5 · Aspectos técnicos de XBRL
5.1 · Visión general
A medida que evolucionan los marcos regulatorios y de cumplimiento, las organizaciones deben entender cómo implementar y usar XBRL de forma efectiva para garantizar la transparencia, la comparabilidad y el cumplimiento de los requerimientos de reporte. Esta sección ofrece una visión general de las taxonomías XBRL, la validación de datos, los formatos de reporte y las mejores prácticas en la gestión de taxonomías. Ya sea para seleccionar una taxonomía adecuada, preparar reglas de reporte (filing rules) o gestionar las actualizaciones y revisiones de una taxonomía, esta sección da a los reguladores, supervisores y demás grupos de interés los conocimientos necesarios para tomar decisiones informadas y mejorar la eficiencia del reporte.
Objetivos de aprendizaje
Al terminar esta sección, los lectores podrán:
- Identificar los distintos formatos XBRL disponibles y sus casos de uso.
- Evaluar si conviene adoptar, extender o crear taxonomías propias, según las necesidades regulatorias y de negocio.
- Identificar los componentes de las taxonomías, incluidos los metadatos y las relaciones entre elementos.
- Explicar los componentes de los reportes XBRL y cómo las taxonomías influyen en ellos.
- Aplicar las herramientas y los procesos que se usan para validar datos XBRL y asegurar su exactitud y cumplimiento.
- Comprender los procesos de gobierno, documentación y comunicación que intervienen en la publicación de una taxonomía.
- Aplicar las mejores prácticas para crear y publicar reglas de reporte (filing rules).
- Evaluar las consideraciones y los retos de permitir que las empresas extiendan las taxonomías.
- Desarrollar estrategias para gestionar las actualizaciones y revisiones de las taxonomías.
5.2 · Componentes de una taxonomía XBRL
Objetivos de aprendizaje
Al terminar esta sección, los lectores podrán:
- Comprender el propósito fundamental y la estructura de las taxonomías en el reporte digital.
- Identificar y describir los componentes centrales de una taxonomía, como la definición de conceptos, las relaciones y los elementos estructurales.
- Comprender otros componentes técnicos, como los espacios de nombres (namespaces) que se usan en la definición de una taxonomía.
- Valorar los beneficios de las taxonomías bien estructuradas para mejorar la calidad de los datos, el cumplimiento regulatorio y la transparencia.
Introducción
Un marco XBRL tiene dos componentes principales: las taxonomías XBRL y los reportes XBRL. Las taxonomías definen la estructura y el significado de los datos, mientras que los reportes XBRL contienen los datos reales reportados con base en ese marco taxonómico. Juntos, estos componentes permiten crear reportes digitales consistentes y legibles por máquina.
Las taxonomías sirven de puente entre las definiciones técnicas de los datos y las necesidades reales del reporte de negocio. Aseguran que la información se comunique de forma clara y uniforme, lo que facilita el cumplimiento regulatorio y permite tomar decisiones basadas en datos a escala global.
Una taxonomía es un marco estructurado que define, organiza e interrelaciona datos. Es clave para estandarizar los datos regulatorios y mejorar su calidad, su transparencia y la interoperabilidad de la información entre los grupos de interés.
A continuación se exploran los componentes clave que forman la columna vertebral de una taxonomía.
Definición de conceptos: la base de una taxonomía
Toda taxonomía XBRL se construye sobre conceptos, los bloques básicos que definen qué se puede reportar. Los conceptos representan términos clave de un reporte, como «Ingresos», «Total de activos» o «Emisiones de gases de efecto invernadero». Cada concepto debe estar claramente descrito para que tanto las personas como el software entiendan cómo usarlo y qué tipo de dato espera.
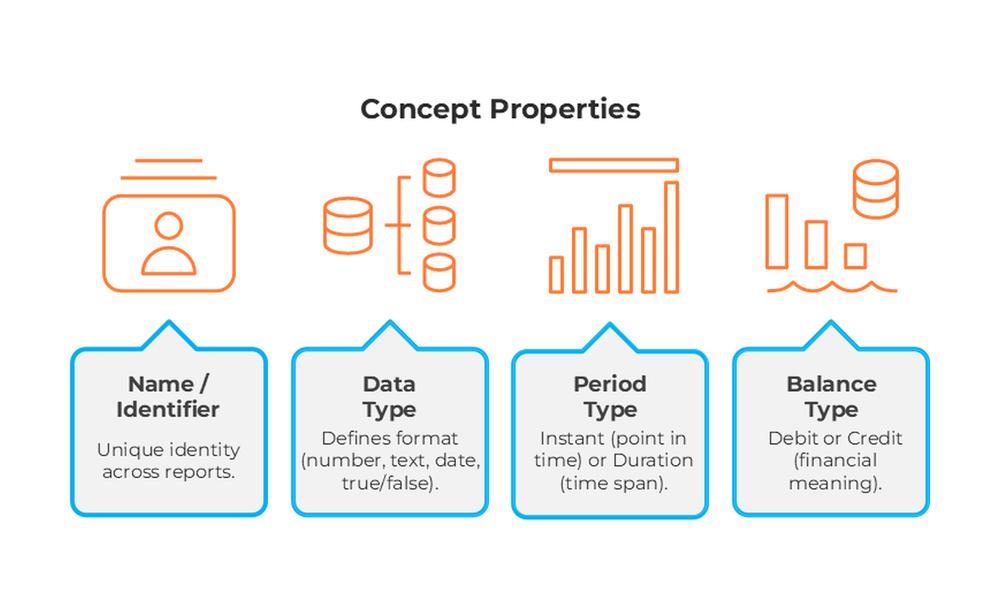
Al diseñar una taxonomía, a cada concepto se le asigna un conjunto de propiedades. Estas propiedades explican qué tipo de valor acepta, cómo se comporta en los reportes y cómo se relaciona con el tiempo, con la naturaleza contable (débito o crédito) y con otras dimensiones del reporte.
Propiedades clave de un concepto
La siguiente tabla explica las propiedades clave que se usan para definir un concepto.
| Propiedad | Qué significa | Por qué importa |
|---|---|---|
| Nombre / identificador | El nombre oficial con el que se hace referencia al concepto. | Asegura que cada concepto se reconozca de forma única en todos los reportes y sistemas. |
| Tipo de dato (data type) | El tipo de valor que el concepto espera (por ejemplo, número, texto, fecha, verdadero/falso). | Ayuda a evitar errores, porque asegura que los datos se reporten en el formato correcto. |
| Tipo de periodo (period type) | Indica si el valor corresponde a un momento específico (instant) o a un lapso de tiempo (duration). | Mantiene alineados y comparables los datos que dependen del tiempo en los distintos reportes. |
| Tipo de saldo (balance type) (opcional) | Expresa la naturaleza contable de un concepto monetario: si es débito o crédito. | Es útil para interpretar los estados financieros. |
Otros elementos de la taxonomía
Además de los conceptos, las taxonomías definen elementos de encabezado que sirven como títulos de sección en la jerarquía de conceptos, como «Estado de situación financiera» en un árbol de presentación. Estos elementos de encabezado no se pueden usar para reportar hechos y técnicamente se marcan como «abstract» (abstractos).
La taxonomía también define elementos estructurales que se usan para construcciones técnicas como cubos, dimensiones, dominios y miembros de dominio. Estos elementos se explican en detalle en el apartado de relaciones dimensionales.
Propiedades adicionales de los elementos
Los elementos de la taxonomía también tienen propiedades adicionales, como «nillable», que indica si un valor puede ser nulo (nil), y «substitution group» (grupo de sustitución), que define si el elemento representa un hecho reportable o algún tipo de elemento estructural.
Ejemplos: conceptos de la taxonomía y sus propiedades
| Nombre del concepto | Tipo de dato | Tipo de periodo | Tipo de saldo | Abstract | Nillable |
|---|---|---|---|---|---|
| Ingresos | monetary | duration | credit | false | true |
| Efectivo y equivalentes al efectivo | monetary | instant | debit | false | true |
| Número de empleados | integer | duration | (ninguno) | false | true |
| IsAudited (¿está auditado?) | boolean (true/false) | duration | (ninguno) | false | true |
| Fecha de reporte | date | instant | (ninguno) | false | false |
| Total de pasivos | monetary | instant | credit | false | true |
| Gastos operacionales | monetary | duration | debit | false | true |
| Descripción de las actividades del negocio | string (texto) | duration | (ninguno) | false | true |
| Estado de situación financiera | string (no es relevante) | duration (no es relevante) | (ninguno) | true | false |
A continuación se muestra un extracto de conceptos de una taxonomía con sus propiedades, tal como se ven en una herramienta de taxonomías.
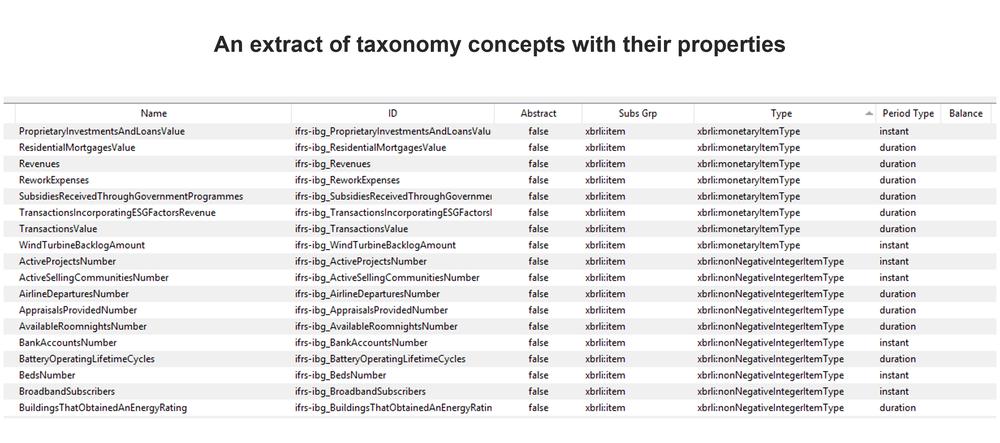
Técnicamente, los elementos de la taxonomía se definen en «archivos XML Schema (XSD)», donde cada elemento se declara con sus propiedades (o «atributos»).
Relaciones: cómo se conectan los puntos en una taxonomía
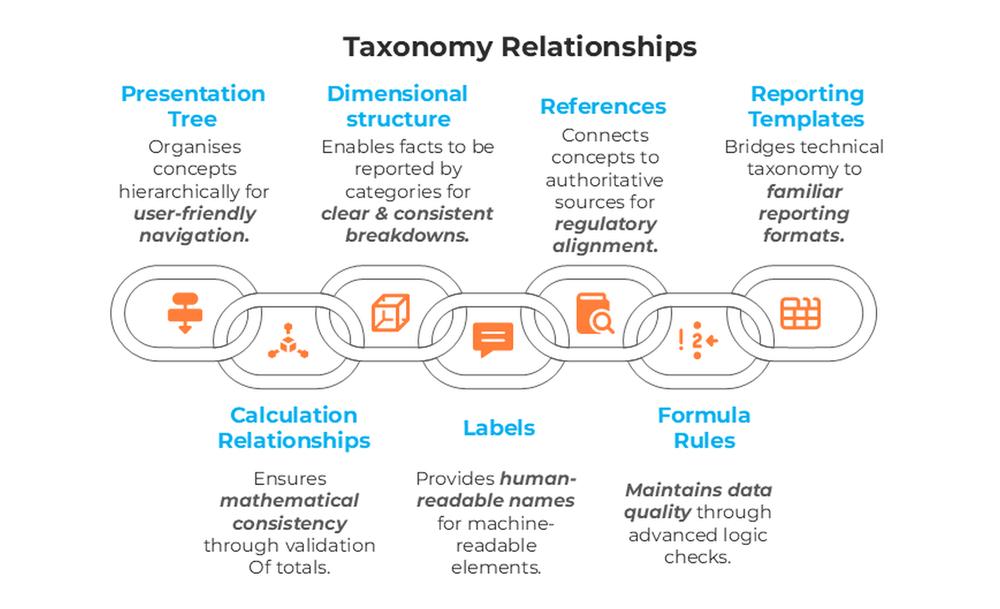
Una taxonomía hace más que definir elementos individuales: también define cómo se relacionan entre sí. Estas conexiones, llamadas relaciones, permiten que la taxonomía represente jerarquías, cálculos, dimensiones, etiquetas, referencias y más.
Sin relaciones, una taxonomía sería solo una lista de definiciones aisladas. Las relaciones de la taxonomía convierten esa lista en una estructura con sentido, que ayuda tanto a las personas como a las máquinas a entender cómo encajan los distintos elementos.
Las construcciones técnicas que se usan para definir relaciones entre elementos de la taxonomía, como las relaciones de presentación, de cálculo y dimensionales, se denominan «linkbases». El término técnico para el objeto que especifica el tipo de una relación en una taxonomía es «arcrole».
Los siguientes apartados explican los principales tipos de relaciones que se encuentran en las taxonomías XBRL; cada uno está diseñado para apoyar un aspecto distinto de la lógica del reporte, la validación, la presentación o la interpretación.
Árbol de presentación: cómo se organizan los elementos de la taxonomía
Una lista simple y sin estructura de conceptos de una taxonomía puede ser difícil de interpretar. Para resolverlo, el árbol de presentación de la taxonomía organiza los elementos en una estructura jerárquica, lo que facilita visualizar y navegar la taxonomía. Por ejemplo, el árbol de presentación de los conceptos financieros refleja la jerarquía de las partidas del balance general o del estado de resultados, como se ve en el siguiente extracto de un árbol de presentación.
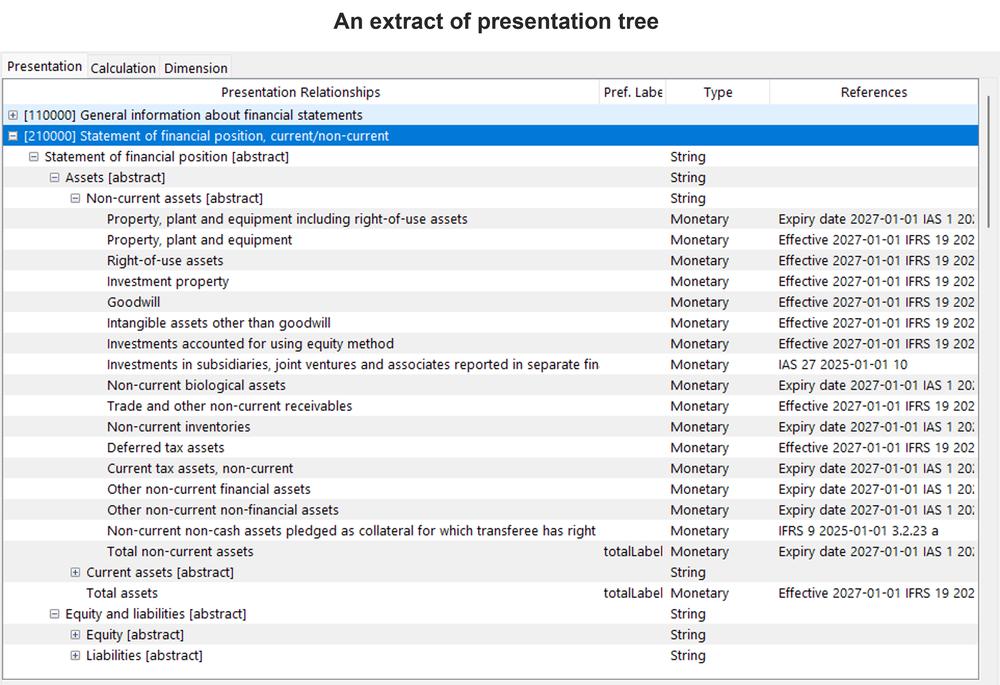
El árbol de presentación se usa para mostrar la estructura de la taxonomía en un formato amigable, que ayuda a las personas a navegarla con más facilidad.
Los elementos de la taxonomía se agrupan en secciones lógicas, como el balance general o el estado de flujos de efectivo. Técnicamente, estos grupos se conocen como «Extended Link Roles» (ELR, roles de enlace extendido). Dentro de cada ELR, los elementos se ordenan jerárquicamente mediante el atributo «order», que determina la posición de cada elemento dentro de su grupo padre. Esto permite varios niveles de anidamiento para reflejar la estructura de los reportes de negocio.
Además, las etiquetas que se muestran en la jerarquía se pueden personalizar. Por ejemplo, el concepto «Activos» podría aparecer como «Total de activos» en el balance general. Esto se controla con el atributo «preferred label» (etiqueta preferida) en el árbol de presentación.
Relaciones de cálculo: validar los totales
El árbol de cálculo define relaciones entre conceptos de una taxonomía con el fin de describir y validar totales y subtotales simples. Un ejemplo de relación de cálculo es: «Activos» = «Activos corrientes» + «Activos no corrientes».
Las relaciones de cálculo ayudan a los usuarios de la taxonomía a entender cómo se relacionan los conceptos numéricos con otros conceptos numéricos de la taxonomía. Sirven de guía a los preparadores de la información para escoger las marcas (tags). El software de validación XBRL marcará una inconsistencia si los valores de los hechos de un reporte no suman según las relaciones de cálculo definidas en la taxonomía. Así, los cálculos XBRL son una herramienta valiosa para definir la semántica de los conceptos y verificar la consistencia de los reportes.
El siguiente es un extracto del árbol de cálculo de una taxonomía, que muestra cómo «Patrimonio y pasivos» se calcula como la suma de «Pasivos» y «Patrimonio». De igual forma, «Activos» se desglosa en «Activos corrientes» y «Activos no corrientes», lo que refleja la estructura del estado de situación financiera.
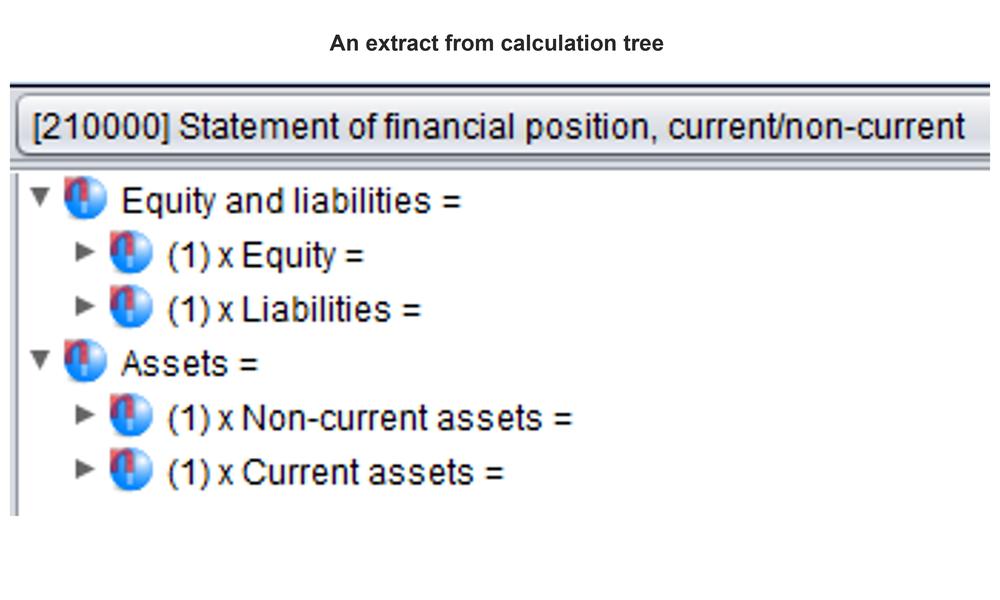
El atributo «weight» (peso) del árbol de cálculo determina si los elementos hijos se suman al total padre o se restan de él. Un peso de 1 significa que el valor se suma, y un peso de -1 significa que se resta.
Por ejemplo, para calcular la «Ganancia bruta», que es «Ingresos» – «Costo de ventas», el concepto «Ingresos» tendrá un peso de +1 y «Costo de ventas» tendrá un peso de -1 en el árbol de cálculo.
Las verificaciones de cálculo aseguran que todos los valores reportados sumen correctamente. Estas reglas se definen una sola vez en la taxonomía y se aplican automáticamente cada vez que se valida un reporte con esa taxonomía.
Ejemplo: verificación de cálculo
Según el árbol de cálculo: «Activos» = «Activos corrientes» + «Activos no corrientes».
Las empresas A y B reportan los siguientes valores en un estado financiero:
| Partida | Valores de la empresa A | Valores de la empresa B |
|---|---|---|
| Activos corrientes | 80.000 | 80.000 |
| Activos no corrientes | 120.000 | 120.000 |
| Activos | 200.000 | 195.000 |
Para la empresa A: 80.000 + 120.000 = 200.000 ✓ Como los valores suman correctamente, la verificación de cálculo se cumple.
Para la empresa B: 80.000 + 120.000 = 195.000 ✗ Esto generaría una advertencia que alerta al preparador de que el total no coincide con la regla definida en la taxonomía.
Relaciones dimensionales: desagregación y calificación de los datos
En el reporte de negocio, la información a revelar (divulgación) a menudo se desglosa por categorías, como región o tipo de cliente. Por ejemplo, una empresa podría reportar sus ingresos por región, así:
- Ingresos – América
- Ingresos – Europa
- Ingresos – Asia-Pacífico
- Ingresos – África
Esto se puede modelar en una taxonomía XBRL creando un concepto separado para cada caso, como «RevenueAmericas», «RevenueEurope», etc. Este enfoque es aceptable y captura la información requerida. Sin embargo, si otros conceptos, como «Ganancia», también deben reportarse por región, habría que crear igualmente conceptos separados como «ProfitAmericas», «ProfitEurope», y así sucesivamente. Esto puede llevar a una gran cantidad de conceptos repetitivos.
XBRL ofrece un enfoque más flexible y escalable mediante la estructura dimensional. En lugar de crear un concepto separado para cada región, se puede definir un concepto como «Ingresos» o «Ganancia» y usar una dimensión, como Región, para desglosar ese concepto. Esto permite reportar hechos como:
- Concepto: Ingresos | Dimensión: Región = África
- Concepto: Ganancia | Dimensión: Región = Europa
El enfoque dimensional evita duplicar conceptos y promueve desgloses consistentes entre varios conceptos, lo que hace que las taxonomías sean más fáciles de gestionar y los reportes más consistentes.
En el reporte de sostenibilidad, la estructura dimensional evita la redundancia y facilita aplicar desgloses similares, por ejemplo por instalación, región o actividad de negocio, a varias métricas de sostenibilidad, como el uso de agua o el consumo de energía.
Componentes clave de la estructura dimensional
- Cubo (hipercubo): una vista multidimensional de los datos que se crea al combinar conceptos con dimensiones. Ejemplo: un cubo podría definir «Ingresos» y «Ganancia» desglosados por «Geografía» y «Línea de producto».
- Dimensiones definidas en la taxonomía: estas dimensiones se crean dentro de la taxonomía para expresar desgloses significativos de los datos, como por región, línea de producto o fuente de emisión. Se llaman dimensiones definidas en la taxonomía para distinguirlas de las dimensiones propias de XBRL, como el periodo, la unidad y la entidad, que se usan para calificar cada hecho de un reporte XBRL. Salvo que se indique otra cosa, cuando en este contexto se usa el término «dimensiones», se refiere específicamente a las dimensiones definidas en la taxonomía. Las dimensiones definidas en la taxonomía son de dos clases: explícitas y tipificadas (typed).
- Dimensiones explícitas: una dimensión explícita tiene una lista predefinida de valores permitidos, llamados «miembros de dominio». Estos se declaran dentro de la taxonomía, de modo que en los reportes solo se pueden usar valores específicos y controlados. Las dimensiones explícitas aseguran la consistencia entre reportes, porque limitan los valores a una lista conocida. Ejemplo: una dimensión «Geografía» puede tener un «dominio» llamado «Continente», que incluye los miembros de dominio África, Europa, Asia-Pacífico, etc.
- Dimensiones tipificadas (typed): una dimensión tipificada admite valores libres pero estructurados. En lugar de una lista de miembros de dominio, la taxonomía define el tipo de dato o el formato que deben seguir los valores (por ejemplo, cadena de texto, fecha, número). Las dimensiones tipificadas son útiles cuando los valores de la dimensión son numerosos, cambiantes o, en la práctica, no se pueden listar exhaustivamente de antemano (por ejemplo, identificadores de entidades, códigos de ubicación). Ejemplo: una dimensión «PostalCode» (código postal) puede admitir cualquier formato válido de código postal (como «110001» o «W1A 1AA»), siempre que cumpla un patrón definido (por ejemplo, una cadena de dígitos o alfanumérica).
- Dominio: un dominio es un conjunto de valores relacionados. Ejemplo: distintos dominios para usar en una dimensión «Geografía» podrían ser «Países», «Continentes» o «Estados».
- Miembro de dominio: un elemento que representa una de las posibilidades dentro de un dominio. Pueden usarse como valores posibles de la dimensión. Ejemplo: «África» es un miembro del dominio «Continente», que se usa con la dimensión «Geografía».
- Valor por defecto de la dimensión (dimension default): el valor que se asume para una dimensión cuando no se indica de forma explícita; por lo general representa el total. Ejemplo: si un hecho reportado de «Ingresos» no especifica un valor para la dimensión «Geografía», se asume que es el total de todas las geografías.
Ejemplo: dimensión explícita definida en la taxonomía
En la siguiente tabla, la información a revelar por segmentos se modela con una estructura dimensional, en la que los conceptos «Ingresos» y «Ganancia» se califican con la dimensión explícita «Geografía». La dimensión «Geografía» incluye tres miembros de dominio predefinidos en la taxonomía: América, Europa y Asia.
| Geografía (dimensión explícita) | América | Europa | Asia |
|---|---|---|---|
| Ingresos (USD) | 1.200.000 | 950.000 | 1.050.000 |
| Ganancia (USD) | 20.000 | 50.000 | 50.000 |
Ejemplo: dimensión tipificada definida en la taxonomía
En la siguiente tabla, la información a revelar sobre consumo de energía se modela con una estructura dimensional, en la que el concepto «Consumo de energía» se califica con la dimensión «Instalación». La dimensión «Instalación» se define como una dimensión tipificada, es decir, acepta valores estructurados, como códigos alfanuméricos de instalación, en lugar de estar restringida a una lista predefinida de miembros especificada en la taxonomía.
| Id. de instalación (dimensión tipificada) | Consumo de energía (kWh) |
|---|---|
| FAC-001 | 500.000 |
| FAC-002 | 450.000 |
| FAC-003 | 520.000 |
Etiquetas: conceptos legibles para las personas
Las taxonomías están diseñadas para ser legibles por máquina, pero la claridad para los usuarios humanos es igual de importante. Las etiquetas (labels) de una taxonomía dan descripciones en texto a los elementos de la taxonomía, que ayudan a los preparadores, revisores y usuarios a interpretar los datos que se reportan.
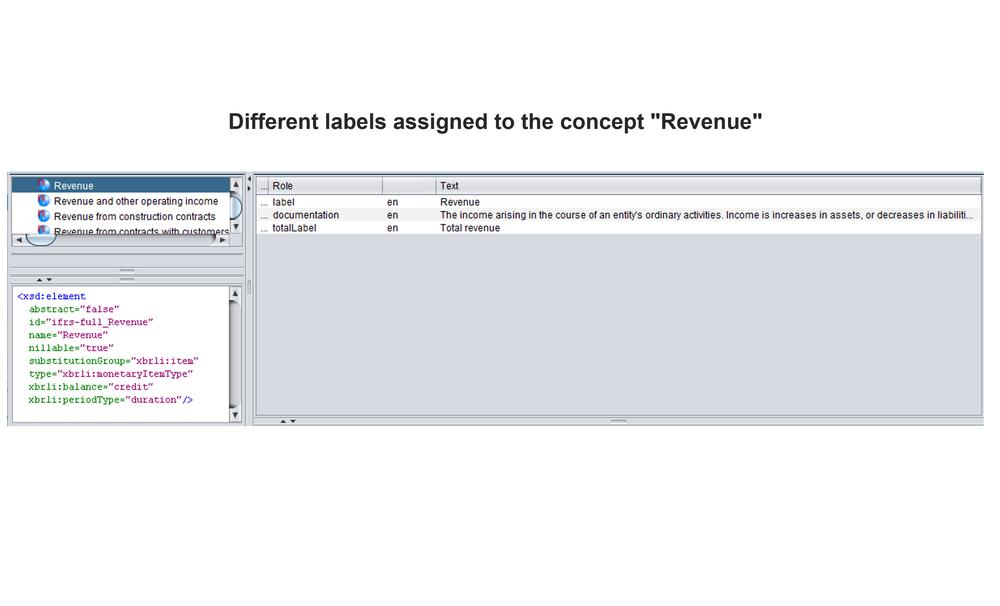
Un mismo componente de la taxonomía puede tener varias etiquetas. Las etiquetas pueden estar en varios idiomas y cumplir distintos propósitos. Los distintos tipos de etiqueta se identifican mediante «roles de etiqueta» (label roles), que definen el propósito de la etiqueta. La etiqueta estándar (definida con el «rol estándar») es la etiqueta por defecto de un concepto. Cada concepto debe tener una etiqueta estándar. Por ejemplo, el concepto «CostOfGoodsSold» tendría una etiqueta estándar como «Costo de los bienes vendidos», que le da un nombre legible para mostrarlo en reportes y herramientas.
Una buena etiqueta estándar debe ser autónoma, única, útil, concisa y consistente en toda la taxonomía. Debe describir con precisión el concepto sin depender de la jerarquía, evitar términos que dependan del contexto y seguir una convención de etiquetado acordada, en aras de la claridad y la uniformidad.
Cuando se definen etiquetas en varios idiomas, el software puede permitir que el lector vea las etiquetas en el idioma que prefiera al consultar un reporte XBRL o una taxonomía. El idioma de una etiqueta se identifica con un código; por ejemplo, «en» identifica el inglés.
Tipos de etiqueta
Para dar una definición más completa de un componente de la taxonomía, se pueden proporcionar varias etiquetas. La forma en que deben entenderse la indica el tipo de etiqueta. Las taxonomías no definen explícitamente dónde ni cómo debe mostrarse cada tipo de etiqueta. Estos son algunos tipos de etiqueta:
- Documentación: explica el componente de la taxonomía y su uso. Ejemplo: «El importe de los pasivos relacionados con los arrendamientos de la entidad. Un arrendamiento es un contrato, o parte de un contrato, que transmite el derecho a usar un activo subyacente durante un periodo de tiempo a cambio de una contraprestación». (Etiqueta de documentación de «Pasivos por arrendamientos»).
- Corta (terse): etiqueta breve, que supone el contexto de los conceptos relacionados. Ejemplo: «Dividendos pagados» (etiqueta corta de «Dividendos pagados, clasificados como actividades de financiación»).
Etiquetas que controlan la presentación de los elementos de la taxonomía
El árbol de presentación tiene un mecanismo (llamado mecanismo de etiqueta preferida) para mostrar diferentes etiquetas del mismo elemento en distintos puntos del árbol. En el siguiente ejemplo, se usa el mismo concepto para dar el saldo al inicio y al final de un periodo. Al concepto se le asignan una «etiqueta de inicio de periodo» y una «etiqueta de final de periodo», que se marcan como etiqueta preferida en los lugares correspondientes del árbol de presentación. La etiqueta estándar del concepto es «Propiedades, planta y equipo».
- Propiedades, planta y equipo al inicio del periodo (etiqueta de inicio de periodo)
- Incremento (disminución) en propiedades, planta y equipo
- Adiciones, propiedades, planta y equipo
- Depreciación, propiedades, planta y equipo
- Disminución, propiedades, planta y equipo
- Propiedades, planta y equipo al final del periodo (etiqueta de final de periodo)
- La «etiqueta de total» (total label) se usa en un árbol de presentación como etiqueta preferida cuando se necesita mostrar una etiqueta diferente como total de un conjunto de otros valores. Ejemplo: «Total pasivos» (para la suma de los pasivos corrientes y no corrientes) es la etiqueta de total del concepto «Pasivos».
- La «etiqueta negada» (negated label) se usa en un árbol de presentación como etiqueta preferida cuando el valor se muestra con el signo contrario al que tiene en el reporte XBRL. Ejemplo: «Costos financieros» debe mostrarse con signo negativo porque reduce el saldo total; por eso se usa una etiqueta «negada», que invierte el signo del valor reportado.
Selección de la etiqueta según el signo de los valores reportados
La denominación de algunos conceptos de la taxonomía puede cambiar según el signo del valor reportado. Por ejemplo, en el caso del concepto «Ganancia (pérdida)», si el valor es positivo se le puede llamar simplemente «Ganancia», y si es negativo se le llama «Pérdida». Para estos casos se pueden definir etiquetas específicas, como la «etiqueta positiva» o la «etiqueta negativa».
El siguiente es un extracto de una herramienta de visualización de taxonomías, que muestra las distintas etiquetas asignadas al concepto «Revenue» (Ingresos).
Para más información sobre cómo funcionan las etiquetas en XBRL, consulte la guía detallada sobre tipos de etiqueta, etiquetas multilingües y buenas etiquetas estándar (en inglés).
Referencias: conectar los conceptos con las normas y la regulación
Los conceptos de una taxonomía suelen tener su origen en una literatura normativa o en una regulación. Las referencias de la taxonomía se usan normalmente para enlazar los conceptos con su definición en esa literatura normativa, como la norma contable o la regulación de reporte pertinente.
Las referencias son información estructurada que se adjunta a un componente de la taxonomía y que lo enlaza con información externa sobre el elemento. Un concepto de la taxonomía puede tener cualquier número de referencias asociadas. Cada referencia está compuesta por varias partes de referencia (reference parts).
Por ejemplo, el concepto «Capital emitido» puede incluir referencias que lo enlazan con su definición en una norma NIIF, así:
Name: IAS
Number: 1
Issue Date: 2022-03-24
Paragraph: 78
Subparagraph: e
En este ejemplo, «Name», «Number», etc., son las partes de referencia.
Las referencias son especialmente útiles para supervisores, reguladores, auditores y preparadores que quieren saber qué regla contable o requisito legal respalda un dato determinado.
Tipos de referencia
Según su tipo, las referencias cumplen distintos propósitos. La siguiente tabla presenta algunos tipos de referencia.
| Tipo de referencia | Propósito | Ejemplo |
|---|---|---|
| Referencia de definición | Da una definición formal del concepto para asegurar una interpretación precisa. | «Ingresos»: enlazado con su definición en la NIC 1. |
| Referencia de información a revelar | Indica que se requieren notas explicativas adicionales en el reporte. | «Pasivos contingentes»: deben revelarse en las notas. |
| Referencia de presentación | Sugiere dónde debe aparecer el concepto en la estructura del reporte. | «Utilidad neta»: debe aparecer al final del estado de resultados. |
| Referencia de medición | Explica cómo debe calcularse o estimarse el valor, con base en las normas aplicables. | «Valor razonable»: enlazado con la NIIF 13 para orientar la valoración. |
| Referencia normativa (standard) | Conecta el concepto con un párrafo o sección específicos de una ley, regulación o norma contable. | «Ingresos»: la NIC 1.82(a) indica los requerimientos de información a revelar en el estado del resultado. |
Información estructurada en las referencias
En la taxonomía se puede incluir información estructurada o metadatos sobre los conceptos; por ejemplo, información de hitos, como la fecha de vigencia, la fecha de obsolescencia o la fecha de creación, o la aplicabilidad del tipo de negocio, el número de formulario o el tipo de reporte pertinentes para los elementos de la taxonomía. Esta información estructurada sobre los componentes de la taxonomía se registra en formato clave-valor mediante referencias de propiedades (property references). Para más detalles, consulte la guía sobre referencias de propiedades (en inglés).
Reglas de fórmula XBRL: asegurar la lógica y la validez de los datos
Mientras algunas relaciones de una taxonomía son estructurales o descriptivas, otras ayudan a imponer la calidad de los datos y la consistencia lógica. En la taxonomía se pueden definir reglas de validación mediante las reglas de fórmula XBRL (XBRL Formula Rules).
Las reglas de fórmula XBRL van más allá de los totales simples: permiten condiciones, umbrales y lógica que deben cumplirse para que los datos se consideren válidos. Son reglas de validación, parecidas a las verificaciones de una hoja de cálculo que aseguran que las fórmulas sean correctas o que los valores estén dentro de los rangos esperados.
El software XBRL conforme (certificado como conforme con las especificaciones XBRL) aplica automáticamente las reglas de fórmula como parte de la validación, lo que facilita a los preparadores revisar los reportes antes de enviarlos. Al definir las reglas de validación en la taxonomía mediante reglas de fórmula XBRL, los receptores de datos (data collectors) evitan que los preparadores y los desarrolladores de software de terceros interpreten mal las reglas.
Las reglas de fórmula XBRL traen funciones incorporadas para trabajar sin tropiezos con datos XBRL y atienden requisitos propios de XBRL, como seleccionar hechos según sus aspectos XBRL, consultar las relaciones de la taxonomía y recorrer los modelos dimensionales XBRL.
Ejemplos de reglas de validación que se pueden definir como reglas de fórmula XBRL:
- «Ingresos» se reporta como un valor positivo.
- Debe reportarse la «Fecha de fin del periodo actual».
- La «Fecha de fin del periodo actual» es posterior a la fecha reportada en «Fecha de inicio del periodo actual».
- El valor total de «Propiedades, planta y equipo» es la suma de sus clases de activos, modeladas con dimensiones.
- El total al final de un periodo de reporte es igual al total al inicio de ese periodo más los cambios ocurridos durante el periodo.
Componentes clave de las reglas de fórmula XBRL
- Nombre de la regla: un identificador de la regla que se usa como código de error si la regla falla.
- Expresión de prueba (test expression): la lógica que se evalúa para determinar el resultado de la regla.
- Variables: las entradas de la expresión de prueba. Por ejemplo, si la expresión de prueba hace una suma, las variables se usan para seleccionar del reporte XBRL el hecho total y los hechos que lo componen.
- Filtros: condiciones que un hecho debe cumplir para ser seleccionado en la prueba de la regla. Por ejemplo, «filtro de concepto = Ingresos» asegura que para la evaluación solo se tomen los hechos reportados con el concepto «Ingresos».
- Precondiciones: algunas reglas requieren evaluar antes validaciones condicionales. Las precondiciones definen los requisitos previos que deben cumplirse antes de validar la regla.
- Mensajes: mensajes que se pueden mostrar cuando la evaluación falla (mensajes de no cumplimiento, unsatisfied messages), para ayudar a entender la naturaleza del problema. Las reglas de fórmula XBRL también permiten definir mensajes de cumplimiento (satisfied messages), que estarán disponibles para los usuarios cuando una regla de validación se evalúe con éxito.
Lea más sobre la validación de datos XBRL en este artículo.
Para más detalle técnico sobre cómo diseñar e implementar reglas de fórmula XBRL, consulte el tutorial de XBRL International sobre reglas de fórmula (en inglés).
Plantillas de reporte: estructura de tabla para captura y visualización de datos
Algunos reportes de negocio van mucho más allá de presentar una jerarquía lineal simple. Algunos reportes deben presentarse en estructuras tabulares multidimensionales, familiares para los usuarios de negocio y para los grupos de interés no técnicos. Las plantillas de reporte resuelven este reto, porque dan a quienes desarrollan la taxonomía más flexibilidad para definir la presentación de los reportes.
Las plantillas de reporte facilitan la captura sencilla de los valores reportados al generar reportes XBRL y una visualización clara de los datos XBRL reportados para los usuarios de negocio.
El siguiente ejemplo ilustra una plantilla de reporte basada en la información a revelar sobre exposiciones por región. En este caso, los conceptos de tipos de exposición se organizan en filas, mientras que las regiones geográficas aparecen como columnas. Esta estructura guía al preparador para capturar los datos multidimensionales de forma precisa y consistente, y alinea cada cifra reportada con su concepto y su desglose regional.
| Tipo de exposición | América | Europa | Asia |
|---|---|---|---|
| Exposición crediticia | |||
| Exposición por inversiones | |||
| Exposición total |
Características de las plantillas de reporte
- Modelado independiente: las plantillas de reporte se modelan con independencia del modelado dimensional de los datos subyacentes. Esto permite que el software presente una vista familiar y amigable de la plantilla, mientras mantiene un modelo de datos lógico y consistente.
- Etiquetado personalizado: las plantillas de reporte pueden definir etiquetas propias para filas y columnas. No es obligatorio usar las etiquetas estándar definidas en la taxonomía para los conceptos y las dimensiones. Las etiquetas estándar suelen ser largas, porque deben ser únicas en toda la taxonomía. En cambio, las plantillas pueden usar etiquetas más cortas y propias del contexto, que mejoran la legibilidad.
- Tablas abiertas: las plantillas de reporte pueden definir tablas abiertas, es decir, que el número de filas, columnas u hojas no es fijo. Esto es útil cuando el número de registros, periodos de reporte o monedas es variable o desconocido, y da a los usuarios la flexibilidad de ampliar la plantilla según lo necesiten.
- Reutilización de relaciones: las plantillas de reporte pueden aprovechar relaciones definidas en otras partes de la taxonomía para construir partes de la plantilla. Por ejemplo, se puede referenciar y reutilizar una jerarquía de elementos primarios definida en un árbol de presentación, sin tener que redefinir la estructura.
Términos clave de la taxonomía
Punto de entrada: apuntar a la parte correcta de la taxonomía
Las taxonomías pueden ser grandes y complejas, y cubrir una gran variedad de necesidades de reporte. Para que sean más fáciles de usar, a menudo se dividen en puntos de entrada, cada uno de los cuales define un subconjunto específico de la taxonomía que corresponde a un escenario de reporte particular.
Un punto de entrada es, en esencia, un paquete de partida formado por definiciones de datos y relaciones seleccionadas, que se centra en los conceptos y las reglas pertinentes para un requerimiento dado. Le indica al software de reporte que empiece por la parte de la taxonomía que aplica al reporte.
Los puntos de entrada hacen que las taxonomías sean más fáciles de usar. En lugar de obligar a los preparadores o a los sistemas a cargar toda la taxonomía, los puntos de entrada les permiten concentrarse solo en el subconjunto pertinente para sus necesidades de reporte. Esto mejora el rendimiento y reduce la complejidad, en particular cuando una taxonomía cubre varios casos de uso o dominios de reporte.
Para los supervisores o reguladores, los puntos de entrada son una forma práctica de definir distintos perfiles de reporte, por ejemplo uno para entidades individuales y otro para grupos consolidados, sin tener que duplicar toda la estructura de la taxonomía. Esta modularidad hace que las taxonomías sean más adaptables y más fáciles de implementar en escenarios diversos.
El siguiente es un ejemplo de una taxonomía de sostenibilidad que incluye un punto de entrada para la información a revelar ambiental y otro para los indicadores sociales.
| Descripción del formulario | Taxonomía completa | Punto de entrada ambiental | Punto de entrada social |
|---|---|---|---|
| Emisiones de gases de efecto invernadero | ✓ | ✓ | |
| Consumo y gestión del agua | ✓ | ✓ | |
| Evaluación de riesgos ambientales | ✓ | ✓ | |
| Iniciativas de relacionamiento con la comunidad | ✓ | ✓ | |
| Métricas de diversidad de la fuerza laboral | ✓ | ✓ | |
| Incidentes de salud y seguridad | ✓ | ✓ | |
| Visión general de la estrategia y el gobierno de sostenibilidad | ✓ | ✓ | ✓ |
Ya sea en el reporte financiero (por ejemplo, estados individuales frente a consolidados) o en la información a revelar sobre sostenibilidad (por ejemplo, indicadores ambientales frente a sociales), los puntos de entrada ayudan a los preparadores y a los sistemas a trabajar solo con la parte pertinente de una taxonomía. Esto mejora la usabilidad, agiliza la validación y asegura que los reportes estén alineados con los requerimientos regulatorios o propios de cada dominio.
Paquetes de taxonomía: todo en un solo lugar
Las taxonomías están formadas por muchos componentes técnicos: esquemas, linkbases, etiquetas, referencias, plantillas, documentación y más. Los paquetes de taxonomía (Taxonomy Packages) facilitan reunir todos estos archivos de forma estandarizada.
Los paquetes de taxonomía incluyen no solo los archivos técnicos, sino también metadatos esenciales, como el nombre de la taxonomía, su versión, la fecha de publicación, la información del publicador y los puntos de entrada definidos. Estos metadatos permiten que los sistemas identifiquen, carguen y apliquen automáticamente los componentes correctos con una configuración mínima.
Los archivos de una taxonomía suelen estar alojados en internet y requieren conexión. Los paquetes de taxonomía ofrecen una solución llamada remapeo (remapping), que redirige las rutas en línea a rutas locales; así se habilita el acceso sin conexión y se ayuda al software a encontrar localmente los archivos de la taxonomía.
Un paquete de taxonomía simplifica la forma de compartir, actualizar y aplicar las taxonomías. En lugar de depender de archivos dispersos en carpetas o URL, los preparadores y los sistemas pueden acceder a un paquete central que entrega la taxonomía completa en un formato consistente.
Para los preparadores, los paquetes de taxonomía ofrecen un conjunto de recursos listo para usar. Para las herramientas de software, permiten detectar automáticamente la estructura y los puntos de entrada. Y para los supervisores o reguladores y los publicadores, aseguran un mayor control sobre el versionamiento y las actualizaciones de la taxonomía.
Lea más sobre los paquetes de taxonomía en esta guía y aquí (en inglés).
Espacios de nombres e identificadores
Cada elemento de la taxonomía debe identificarse de forma única para evitar confusiones, en especial cuando se usan juntas varias taxonomías o extensiones. Esto se logra con los espacios de nombres (namespaces), que funcionan como «apellidos digitales», y con los identificadores, que distinguen cada elemento de forma individual.
Los elementos definidos en la taxonomía ISSB 2024 tienen el espacio de nombres «https://xbrl.ifrs.org/taxonomy/2024-04-26/ifrs-sds». En XBRL, este espacio de nombres normalmente se abrevia con un prefijo, como ifrs-sds, para que las referencias sean más concisas.
Por ejemplo, la taxonomía NIIF (IFRS Taxonomy) puede definir «ifrs:Revenue», mientras que una taxonomía regulatoria local podría definir «reg:Revenue». Aunque ambas usan la etiqueta «Revenue», los prefijos ifrs y reg, que representan sus respectivos espacios de nombres, aseguran que las herramientas de software no confundan uno con otro.
Extensiones de la taxonomía
La extensión es una capacidad clave de XBRL. Las taxonomías definidas por los emisores de normas de reporte (por ejemplo, la taxonomía NIIF) pueden ser extendidas por los receptores de datos para incluir partidas de reporte específicas; estas se conocen como extensiones regulatorias.
Las empresas también pueden extender la taxonomía para reportar información a revelar propia de la entidad.
El punto de partida que se usa para extender una taxonomía se llama taxonomía base. Sus elementos y relaciones pertinentes se reutilizan para construir la taxonomía de extensión.
Los propietarios de las taxonomías base dan orientación sobre cómo pueden extenderse sus taxonomías, mientras que el alcance de las extensiones que pueden hacer las empresas lo determinan los receptores de datos.
Resumen
En el reporte digital, una taxonomía bien estructurada hace más que definir datos: especifica cómo se organiza, se valida y se entiende la información, tanto por los sistemas como por los grupos de interés. Cada componente, desde los esquemas y las relaciones hasta las etiquetas y las plantillas, cumple un papel específico para asegurar que los datos reportados no solo sean exactos, sino también significativos y comparables.
Al adoptar y comprender bien estos componentes, las organizaciones pueden ir más allá del cumplimiento básico y lograr prácticas de reporte más eficientes, transparentes y confiables. Las taxonomías se convierten en una base de confianza para el intercambio de datos, y permiten que supervisores, reguladores, preparadores y usuarios hablen un lenguaje digital común.
Texto original en inglés: https://playbook.xbrl.org/