Inicio › Capítulos › Capítulo 5 · Aspectos técnicos de XBRL
5.6 · Proceso de desarrollo de taxonomías
42 min de lectura
5.6 · Proceso de desarrollo de taxonomías
Objetivos de aprendizaje
Al terminar esta sección, los lectores podrán:
- Distinguir entre las fases de negocio y las fases técnicas del desarrollo de una taxonomía.
- Establecer reglas y principios integrales de modelado de datos que den coherencia a toda la arquitectura de la taxonomía, incluidas las convenciones de nombres de los elementos y la clasificación de la información en métricas, dimensiones y formatos estructurales.
- Desarrollar procesos sistemáticos de mapeo regulatorio que definan el alcance del reporte, determinen los niveles de granularidad adecuados y alineen los requerimientos de datos con los calendarios de envío.
- Crear modelos de datos de alta calidad mediante la construcción estructurada de un diccionario de datos, el diseño lógico de las tablas de reporte y la definición integral de las reglas de negocio.
- Recorrer el proceso de implementación técnica con editores de taxonomías XBRL, incluidos la selección de herramientas, la definición de espacios de nombres (namespaces), la creación de elementos y el desarrollo de árboles de presentación, relaciones de cálculo y estructuras dimensionales.
- Implementar componentes avanzados de la taxonomía, como reglas de fórmula, estructuras de table linkbase, recursos de etiquetas y mapeos de referencias.
- Ejecutar procedimientos integrales de validación y prueba que verifiquen el cumplimiento técnico y la exactitud del contenido de negocio.
- Gestionar el desarrollo de la taxonomía como un proceso iterativo y guiado por el negocio, que equilibra los requerimientos regulatorios con las necesidades prácticas de implementación.
- Aplicar un marco sistemático para gestionar con eficacia proyectos complejos de desarrollo de taxonomías.
Introducción
El desarrollo de una taxonomía XBRL sigue un proceso estructurado, que va del diseño de alto nivel a la implementación técnica y la validación. Comienza con el mapeo de los requerimientos regulatorios en un modelo de datos de negocio; luego ese modelo se traduce en archivos técnicos de taxonomía con herramientas, esquemas y linkbases, y por último se valida para asegurar su exactitud y usabilidad.
Las decisiones que se toman en cada etapa afectan directamente la calidad de los datos, la facilidad de uso para los preparadores y el análisis regulatorio. Una visión general clara ayuda a los supervisores o reguladores y a los grupos de interés a planear con más eficacia la implementación de XBRL, de modo que las expectativas, los recursos y los plazos queden alineados. Esta sección explica las consideraciones de cada etapa y resalta las decisiones prácticas y los compromisos (trade-offs) que determinan el éxito de la taxonomía final.
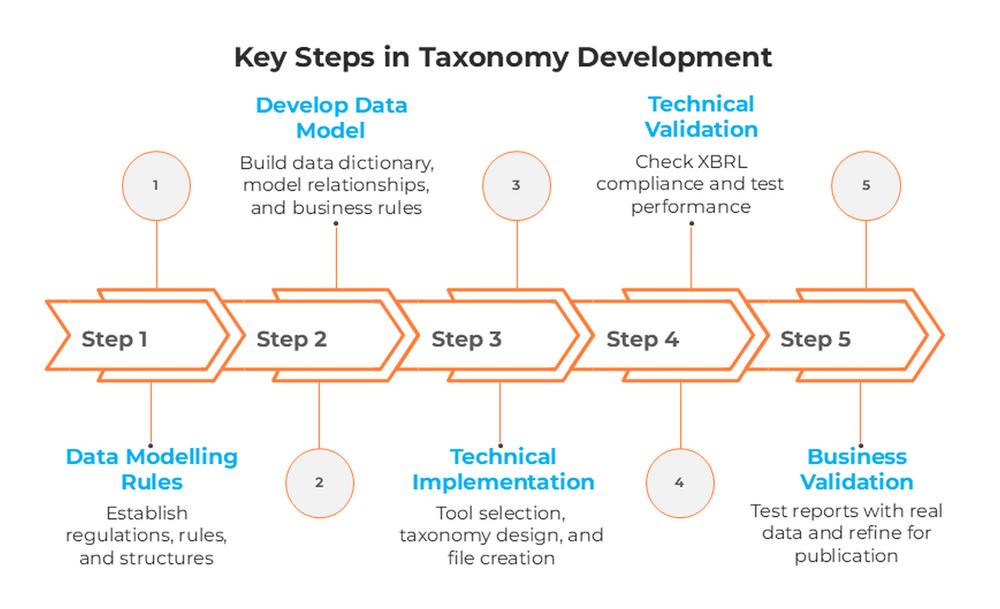
Paso 1: Reglas y principios de modelado de datos
La base de cualquier implementación XBRL exitosa empieza con la preparación de un modelo de datos completo, aunque en esta etapa de alto nivel, junto con la recopilación de la información relacionada y la elaboración de otra documentación no técnica. Esto ocurre antes de que comience cualquier trabajo técnico, y establece el plano de todo el sistema de reporte al definir qué información se debe recolectar, cómo se debe estructurar y qué reglas rigen su uso. El modelo de datos sirve como plano arquitectónico antes de construir la taxonomía XBRL objetivo: entre más claros y completos sean estos planos, más exitosa será la implementación final.
Mapeo regulatorio
El mapeo regulatorio es el primer paso, crítico, para entender exactamente qué información debe capturar el sistema de reporte y entregar a las entidades que reportan. Este proceso consiste en documentar de forma sistemática el alcance completo de los requerimientos de reporte, recopilando todos los documentos fuente, como actos legales, documentos regulatorios y guías de reporte. Además, deben definirse el nivel de detalle necesario y la frecuencia y el momento de envío de los reportes.
El alcance del reporte define los límites de qué información queda dentro del sistema de reporte y qué queda por fuera. Por ejemplo, un supervisor bancario podría determinar que el alcance incluye todas las instituciones que captan depósitos, pero excluye las compañías de seguros y los fondos de inversión. Un registro mercantil puede recolectar datos de las empresas que superen ciertos umbrales de valor del balance, ingresos o número de empleados. Establecer límites claros de alcance evita confusiones durante la implementación y asegura que la taxonomía cumpla el propósito para el que fue creada.
La granularidad se refiere al nivel de detalle que se exige en la información reportada. Distintos programas de reporte requieren enfoques distintos de granularidad. Algunos pueden exigir un marcado muy detallado, en el que cada partida se marca por separado (p. ej., cada hecho reportado del balance, del estado de resultados o del flujo de efectivo), lo que permite un análisis y una comparación precisos. Otros pueden aceptar enfoques de bloques de texto, en los que secciones completas de los reportes, como las notas explicativas de los estados financieros, se capturan como unidades únicas; esto ofrece menos precisión analítica, pero reduce la carga de preparación.
Los calendarios de envío definen el momento y la frecuencia de los reportes:
- Reportes mensuales: datos operativos que requieren una recolección y un análisis rápidos.
- Reportes trimestrales: métricas de desempeño y análisis de tendencias.
- Reportes anuales: evaluaciones integrales e información prospectiva.
El proceso de mapeo regulatorio debe alinear los requerimientos de datos con las frecuencias de envío, teniendo en cuenta que un reporte más frecuente puede requerir estructuras de datos más sencillas para asegurar el cumplimiento oportuno.
Reglas de modelado
Establecer reglas de modelado claras da coherencia a toda la taxonomía y asegura que la información similar se trate de manera uniforme en todo el sistema. Estas reglas son los principios orientadores que usan los arquitectos de la taxonomía al tomar decisiones de diseño sobre cómo representar los distintos tipos de información. Hay al menos dos enfoques de modelado de uso común. El primero es el Data Point Model (modelo de puntos de datos), muy usado en la supervisión del mercado financiero europeo para recolectar datos de bancos, compañías de seguros y fondos de pensiones. El segundo son las arquitecturas de taxonomías contables, como la de las IFRS, que usan comúnmente los supervisores del mercado de valores o los registros mercantiles para recolectar datos de empresas de capital privado.
Las convenciones de nombres de los elementos son la base de una estructura de taxonomía coherente. Estas convenciones establecen cómo se nombrarán los conceptos, de modo que los usuarios puedan entender y ubicar fácilmente la información pertinente. Los patrones de nombres consistentes ayudan a los preparadores a navegar la taxonomía con más eficiencia y reducen la probabilidad de errores al crear el reporte, cuando un mismo hecho reportado recibe nombres distintos a lo largo de la taxonomía (p. ej., «Activos de corto plazo» frente a «Activos corrientes»). Las convenciones deben ser intuitivas para los usuarios y, a la vez, mantener la precisión técnica que exige el procesamiento automatizado. El documento de arquitectura de la taxonomía IFRS mencionado arriba define estas reglas en la sección Style Guide (guía de estilo).
El otro aspecto que deben abordar las reglas de modelado es la clasificación de la información en métricas o dimensiones, una decisión fundamental de diseño que afecta cómo se pueden analizar y comparar los datos. Las métricas suelen representar valores medibles, como importes monetarios, porcentajes o conteos. Las dimensiones aportan el contexto que califica esas métricas, como regiones geográficas, periodos de tiempo o segmentos de negocio. Una clasificación adecuada asegura que los datos resultantes puedan atender los requerimientos analíticos de quienes los reciben y los consumen.
La información se puede organizar en distintas estructuras:
- Listas: para datos secuenciales o jerárquicos en los que el orden importa (p. ej., las partidas del balance).
- Tablas: para información multidimensional en la que los puntos de datos se califican por varias características al mismo tiempo (p. ej., cambios en el patrimonio o segmentos de operación).
- Bloques de texto: para información narrativa que no encaja en formatos estructurados.
Al diseñar tablas, la distinción entre dimensiones abiertas y cerradas se vuelve crucial. Los ejes cerrados tienen valores predeterminados y fijos entre los que los preparadores deben elegir, lo que asegura la consistencia y la comparabilidad entre reportes. Los ejes abiertos permiten que los preparadores agreguen sus propios valores, lo que da flexibilidad para las circunstancias propias de cada entidad, pero puede reducir la comparabilidad. La elección entre enfoques abiertos y cerrados depende de los objetivos del reporte y de la diversidad de las entidades que reportan.
En el contexto del reporte ASG, las dimensiones abiertas incluyen los segmentos de operación, que son propios de cada entidad. Esta flexibilidad permite que una empresa de tecnología defina segmentos como «Servicios en la nube», «Hardware» y «Licenciamiento de software», mientras que una empresa manufacturera podría usar «Producción», «Distribución» e «Investigación y desarrollo». Un ejemplo de dimensión cerrada es la lista de países que pertenecen al Espacio Económico Europeo, que podría exigir elegir de una lista estandarizada de códigos de país ISO, lo que asegura una clasificación geográfica consistente.
Paso 2: Desarrollo del modelo de datos
Las reglas o principios de modelado establecen la base para desarrollar un modelo de datos. Creado por expertos de negocio, como especialistas en política regulatoria o usuarios de los datos, este artefacto no técnico y orientado al negocio define con precisión el alcance y las características de los datos reportados. El modelo de datos es un componente crítico del marco de reporte objetivo e influye de manera significativa en la calidad de los datos recolectados.
Un modelo de datos de mala calidad, que por falta de validación de las reglas de modelado contiene conceptos duplicados, muy probablemente dará lugar a una taxonomía XBRL que contendrá esa duplicación y, como consecuencia, reducirá la calidad de los datos recolectados. En cambio, un modelo de datos de alta calidad ofrece requerimientos claros y explícitos y, cuando se convierte adecuadamente en la taxonomía XBRL, constituye una base sólida para el reporte de los datos objetivo.
En cuanto a herramientas, un modelo de datos se puede desarrollar con una hoja de cálculo como Microsoft Excel o con software dedicado a este propósito. Las soluciones dedicadas ofrecen funcionalidades que permiten a los usuarios definir principios y reglas de modelado que aseguran automáticamente que ciertos artefactos, como los conceptos, se respeten. Usar una hoja de cálculo exige más autodisciplina y más verificaciones manuales para asegurar que se respeten las reglas de modelado establecidas.
Desarrollo del diccionario de datos
El primer paso para desarrollar un modelo de datos es crear un diccionario de datos que, con base en las reglas de nombres acordadas y en la clasificación en métricas, dimensiones y miembros de dominio, defina todos los conceptos únicos de un marco de reporte objetivo. Con base en los requerimientos formales, las métricas se definen por sus tipos de datos y corresponden a actos legales o a documentación formal.
Un diccionario de datos generalmente contiene estructuras limitadas, principalmente listas anidadas, que facilitan la navegación por un gran número de conceptos.
Al crear el diccionario de datos, los autores deben asegurarse de que estén definidos todos los conceptos de las tablas de reporte objetivo y de las demás estructuras de reporte.
Diseño de tablas de reporte y otras estructuras de reporte
Desarrollar la estructura lógica de los conceptos de reporte y de sus relaciones establece cómo se conectan las distintas piezas de información para formar un todo coherente. Este marco ofrece la base intelectual de la taxonomía y orienta las decisiones sobre cómo organizar y relacionar los conceptos dentro de listas de reporte, tablas de dos o más dimensiones, o información textual anidada o no anidada.
El marco conceptual identifica agrupaciones naturales de conceptos relacionados y establece relaciones jerárquicas entre conceptos generales y específicos. También define cómo interactúan los conceptos de distintas áreas de reporte y dónde se podría compartir información o hacer referencias cruzadas entre distintas partes del sistema de reporte.
La estructura y el contenido de las tablas y anexos de reporte requeridos traducen el marco conceptual en formatos de reporte prácticos que los preparadores pueden entender y diligenciar. Este proceso de diseño considera tanto las necesidades analíticas de los receptores de datos como las limitaciones prácticas que enfrentan los preparadores de los datos.
La coordinación de los anexos asegura que la información reportada en distintas tablas o en distintos momentos se mantenga consistente y permita un análisis integral. Esta coordinación identifica dónde podría aparecer la misma información en varios contextos y establece reglas para asegurar su consistencia.
Definición de las reglas de negocio
Las reglas de negocio definen las restricciones lógicas y los requisitos de validación que deben cumplir los datos reportados. Estas reglas aseguran la calidad y la consistencia de los datos y evitan errores comunes que podrían restarle utilidad a la información recolectada. Las reglas de negocio incluyen:
- Reglas de validación lógica: establecen relaciones matemáticas y lógicas entre distintos puntos de datos, como el total de activos, que debe ser igual a la suma de los activos corrientes y los activos no corrientes. Estas reglas permiten verificar automáticamente la consistencia del reporte y ayudan a identificar posibles errores antes o durante el proceso de envío del reporte de negocio.
- Restricciones de negocio: definen los rangos o las características aceptables para los distintos tipos de información. Los importes monetarios pueden tener umbrales mínimos y máximos. Las fechas pueden restringirse a periodos específicos. Los campos de texto pueden exigir formatos o excluir ciertos caracteres. Unas restricciones bien definidas mejoran la calidad de los datos y reducen la necesidad de depurarlos manualmente.
- Reglas de validación cruzada: establecen requisitos que abarcan varios puntos de datos relacionados o varios periodos de reporte. Pueden exigir que ciertas razones estén dentro de rangos esperados o que se expliquen los cambios entre periodos cuando superen umbrales especificados. Las reglas de validación cruzada ayudan a identificar circunstancias inusuales que merecen atención adicional de los analistas.
Referencias legales
Cada concepto definido en el diccionario de datos debe mapearse a los actos legales, regulaciones o guías oficiales pertinentes, creando una trazabilidad clara entre los requerimientos de reporte y su fundamento legal. Este mapeo sirve para varios propósitos: justifica la existencia de cada concepto, ayuda a los preparadores a entender la autoridad que respalda cada requerimiento, apoya la verificación del cumplimiento legal y facilita el mantenimiento cuando cambian los requisitos legales.
El proceso de mapeo de referencias identifica las disposiciones legales específicas que exigen cada dato. Esto puede incluir legislación primaria, reglamentos de aplicación, normas técnicas o guías interpretativas. Unas referencias legales completas ayudan a los preparadores a entender no solo qué deben reportar, sino por qué deben reportarlo y cómo encaja en el marco regulatorio más amplio.
La documentación de las referencias debe ser lo suficientemente detallada para que los preparadores puedan ubicar por sí mismos las disposiciones legales pertinentes. Esto incluye formatos de cita que sigan las convenciones jurídicas locales y un detalle suficiente para identificar secciones o párrafos específicos. Las referencias claras también apoyan el mantenimiento de la taxonomía, porque permiten a los arquitectos hacer seguimiento a los cambios legales que exigen actualizarla.
Paso 3: Implementación técnica con editores de taxonomías XBRL
El paso del diseño conceptual a la implementación técnica es un punto de inflexión crucial en el desarrollo de la taxonomía. Esta etapa transforma los requerimientos de negocio, cuidadosamente elaborados, y el modelo de datos en componentes XBRL funcionales que los sistemas de software pueden procesar y validar. La calidad y la precisión de esta traducción determinan directamente si la taxonomía final cumplirá con eficacia el propósito para el que fue creada.
Entender esta etapa de implementación es esencial para los representantes de los reguladores, porque las decisiones técnicas que se toman aquí influirán en cómo interactúan los preparadores con la taxonomía, en cómo los receptores de datos reciben y procesan la información y en qué tan bien logra todo el programa de reporte sus objetivos de política. A diferencia de las etapas anteriores, centradas sobre todo en la lógica de negocio, este paso exige una colaboración estrecha entre expertos de negocio y especialistas técnicos para que nada se pierda en la traducción.
Selección de herramientas
La base de una implementación técnica exitosa empieza por seleccionar herramientas de desarrollo de taxonomías XBRL adecuadas a la complejidad del proyecto, a las capacidades del equipo y a los requisitos de mantenimiento a largo plazo. Las herramientas de desarrollo de taxonomías se dividen en varias categorías, cada una diseñada para apoyar distintos aspectos del proceso de creación y distintos niveles de experiencia técnica.
Los entornos profesionales de autoría de taxonomías ofrecen una funcionalidad completa para crear, editar y validar taxonomías complejas. Estas herramientas suelen ofrecer interfaces gráficas que permiten a los expertos de negocio participar directamente en el proceso de creación técnica, mientras generan automáticamente el código XML subyacente que exige la especificación XBRL. Normalmente incluyen motores de validación integrados que verifican el cumplimiento técnico a medida que se desarrolla la taxonomía, lo que ayuda a identificar y resolver problemas antes de que queden incrustados en el producto final.
Con frecuencia, los editores de taxonomías permiten importar el modelo de datos desarrollado previamente, lo que reduce significativamente el esfuerzo necesario para migrar esa información. Esta función reduce significativamente el riesgo de malas interpretaciones causadas por volver a digitar manualmente el modelo de datos en un editor de taxonomías.
Los editores especializados de esquemas se centran principalmente en los aspectos técnicos de la creación de la taxonomía y ofrecen un control detallado de las estructuras de XML Schema y de las funciones específicas de XBRL. Estas herramientas son especialmente valiosas al crear taxonomías que requieren funciones técnicas sofisticadas o al integrarse con infraestructura técnica existente. Sin embargo, suelen exigir mayor experiencia técnica y pueden ser menos accesibles para los expertos de negocio que necesitan contribuir al proceso de desarrollo de la taxonomía.
Las plataformas de desarrollo colaborativo combinan capacidades de autoría de taxonomías con funciones de gestión de proyectos, lo que permite que equipos distribuidos trabajen juntos con eficacia. Estas plataformas se vuelven especialmente importantes cuando en el desarrollo de la taxonomía participan varias organizaciones o cuando el cronograma de desarrollo se extiende por periodos largos. La capacidad de hacer seguimiento a los cambios, gestionar versiones y coordinar los aportes de distintos miembros del equipo puede mejorar significativamente la eficiencia y la calidad del proceso de desarrollo.
El proceso de selección debe considerar no solo los requerimientos inmediatos del proyecto de taxonomía actual, sino también las necesidades de largo plazo de mantenimiento y evolución de la taxonomía. Una herramienta no solo debe atender los requerimientos para desarrollar la primera versión pública de una taxonomía XBRL. Idealmente, también debe dar un soporte adecuado a las actualizaciones continuas de la taxonomía, con gestión de versiones e integración con los sistemas de recolección de datos. Además, la disponibilidad de soporte técnico, recursos de capacitación y comunidades de usuarios puede influir significativamente en el éxito de la implementación.
Arquitectura técnica
Convertir el modelo de datos en las especificaciones técnicas XBRL que conforman una taxonomía XBRL exige atención sistemática a cada componente que contribuye a la funcionalidad de la taxonomía. Este proceso de conversión debe preservar la lógica de negocio capturada en las fases anteriores y, a la vez, optimizar la implementación técnica en cuanto a desempeño, mantenibilidad y experiencia de usuario.
Definición del espacio de nombres (namespace)
Una vez seleccionadas las herramientas adecuadas, el equipo de desarrollo de la taxonomía debe establecer identificadores únicos para la taxonomía que eviten conflictos cuando distintos sistemas de reporte operan juntos. Este proceso de definición del espacio de nombres (namespace) responde a un reto fundamental del reporte digital: asegurar que cada componente de la taxonomía tenga una identidad globalmente única que no se pueda confundir con componentes similares de otras fuentes.
El proceso de diseño del espacio de nombres exige considerar con cuidado cómo se usará la taxonomía, tanto ahora como en el futuro. Los identificadores que se elijan hoy aparecerán en todos los reportes creados con la taxonomía, por lo que deben mantenerse estables y accesibles durante todo el ciclo de vida del programa de reporte. Este requisito de estabilidad implica que las decisiones de diseño del espacio de nombres deben evitar depender de estructuras organizacionales o de sistemas técnicos que puedan cambiar con el tiempo.
Definición de elementos
Crear los archivos centrales de esquema XBRL transforma el diseño del espacio de nombres y las especificaciones del modelo de datos en la base técnica que define cómo funcionará la taxonomía. El desarrollo del esquema exige traducir los conceptos de negocio en construcciones de XML Schema, asegurando el cumplimiento de los requisitos de la especificación XBRL y manteniendo la compatibilidad con el software de procesamiento.
El proceso de desarrollo del esquema empieza por definir los tipos de datos fundamentales que soportará la taxonomía. Los tipos de datos estándar de XBRL cubren la mayoría de los requerimientos de reporte comunes, incluidos importes monetarios, porcentajes, fechas y texto. Sin embargo, algunos dominios de reporte especializados pueden requerir tipos de datos personalizados que aporten funcionalidad o capacidades de validación adicionales. La selección y la definición de los tipos de datos influyen directamente en cómo los preparadores ingresarán la información y en cómo los sistemas de validación verificarán la calidad de los datos.
Las definiciones de elementos dentro del esquema establecen los bloques de construcción que los preparadores usarán para marcar sus reportes. Cada elemento debe especificarse cuidadosamente, con los atributos y los requisitos de validación adecuados. La precisión de estas definiciones determina si los datos resultantes cumplirán los requerimientos analíticos documentados en el modelo de datos.
Lea más sobre los componentes de una taxonomía en este artículo.
Árbol de presentación
Establecer relaciones jerárquicas padre-hijo entre los elementos crea la estructura lógica que verán los preparadores al navegar la taxonomía. El árbol de presentación es la interfaz principal entre la implementación técnica de la taxonomía y los usuarios que deben aplicarla a sus requerimientos de reporte.
El proceso de diseño del árbol de presentación exige considerar con cuidado cómo piensan los preparadores su información y cómo organizan de forma natural sus procesos de reporte. Los árboles de presentación eficaces siguen jerarquías de negocio lógicas que reflejan la estructura de los reportes típicos del dominio correspondiente.
Las relaciones jerárquicas dentro del árbol de presentación pueden servir para varios propósitos más allá de la simple organización. Las relaciones padre-hijo pueden indicar requisitos de agregación, dependencias lógicas o relaciones de contexto que ayudan a los usuarios a entender cómo se relacionan entre sí las distintas piezas de información. Estas relaciones también aportan información valiosa a los sistemas de análisis que necesitan entender la estructura de los datos reportados.
Relaciones de cálculo
Capturar las relaciones requeridas entre conceptos, como «concepto a + concepto b = concepto c», permite validar automáticamente la consistencia matemática de los datos reportados. Las relaciones de cálculo cumplen funciones tanto de aseguramiento de la calidad como de orientación al usuario: ayudan a los preparadores a identificar posibles errores y dan a los analistas confianza en la integridad matemática de la información recolectada.
El proceso de definir las relaciones de cálculo exige una revisión sistemática de todas las dependencias matemáticas dentro del modelo de datos. Estas relaciones pueden ser sumas y restas sencillas o fórmulas más complejas que involucran varias variables y lógica condicional. Cada relación debe especificarse con precisión para permitir la validación automatizada y, al mismo tiempo, ser comprensible para los preparadores, que necesitan entender cómo se verificarán sus datos.
Las estructuras de árbol de cálculo organizan las relaciones matemáticas en agrupaciones lógicas que reflejan jerarquías de negocio naturales. Solo a modo de ilustración, el árbol de cálculo de un balance podría empezar con el total de activos en la parte superior, desglosarse en activos corrientes y no corrientes en el segundo nivel y subdividirse luego en categorías de activos específicas. Este enfoque jerárquico ayuda a los preparadores a entender tanto los requisitos matemáticos como la lógica de negocio que sustenta las relaciones.
Dimensiones
Establecer marcos dimensionales dentro de la taxonomía permite capturar información de negocio multidimensional que refleja las complejas realidades de los requerimientos de reporte modernos. Las estructuras dimensionales transforman puntos de datos simples en información rica en contexto, al definir las características calificadoras que especifican exactamente qué representa cada hecho reportado. Este enfoque arquitectónico responde al reto fundamental de que la mayor parte de la información de negocio no se puede entender de manera significativa sin conocer las circunstancias específicas, los periodos, las regiones geográficas o los segmentos de negocio a los que se refiere.
La arquitectura dimensional surge directamente de las decisiones de modelado tomadas en las fases anteriores sobre los requisitos de dimensiones abiertas y cerradas. Estas decisiones de arquitectura determinan si los preparadores deben elegir los valores de las dimensiones de listas predeterminadas o si pueden definir sus propias categorías de contexto para reflejar circunstancias propias de la entidad. Las dimensiones cerradas aportan consistencia y comparabilidad al limitar a los preparadores a esquemas de clasificación estandarizados, como listas predefinidas de países, monedas o normas contables. Las dimensiones abiertas ofrecen flexibilidad para situaciones propias de cada entidad, al permitir que los preparadores definan sus propios valores de dimensión, como segmentos de negocio que reflejen su estructura operativa particular o categorías de productos alineadas con sus reportes internos de gestión.
Las estructuras de datos multidimensionales, definidas como cubos, combinan conjuntos de dimensiones calificadoras con conceptos reportados para crear marcos de información integrales. A diferencia de los objetos físicos tridimensionales, estas estructuras analíticas pueden acomodar cualquier número de dimensiones a la vez, lo que permite análisis sofisticados a través de múltiples características de negocio. Una sola cifra de ingresos, por ejemplo, podría calificarse con dimensiones de región geográfica, segmento de negocio, norma contable y periodo de reporte, lo que da a los analistas una comprensión precisa de lo que representa el importe reportado.
El proceso de diseño del marco dimensional exige un equilibrio cuidadoso entre la sofisticación analítica y la facilidad de uso práctica. Cada dimensión adicional aumenta el poder analítico de los datos recolectados, pero también agrega complejidad para los preparadores, que deben entender y aplicar correctamente la estructura dimensional. La arquitectura debe atender los requerimientos analíticos identificados durante el modelado de datos y, a la vez, seguir siendo clara para preparadores con distintos niveles de experiencia técnica.
Reglas de fórmula
Incorporar las reglas de validación como reglas de XBRL Formula permite verificaciones automatizadas sofisticadas que van más allá de las relaciones matemáticas simples. Las reglas de fórmula pueden implementar lógica de negocio compleja, requisitos de referencias cruzadas y validaciones condicionales que aseguran que los datos reportados cumplan los estándares de calidad y consistencia adecuados al dominio de reporte.
El desarrollo de las reglas de fórmula exige una colaboración estrecha entre los expertos de negocio, que entienden los requisitos de validación, y los especialistas técnicos, que pueden implementarlos con eficacia. Las reglas de validación de negocio identificadas en las fases anteriores deben traducirse a la sintaxis de fórmulas, preservando su función prevista y ofreciendo mensajes de error claros cuando ocurran incumplimientos.
La complejidad de las reglas debe equilibrarse con consideraciones de desempeño del procesamiento y de mantenibilidad. Las reglas muy complejas pueden ofrecer una cobertura de validación completa, pero podrían crear cuellos de botella de desempeño durante el procesamiento de los reportes o volverse difíciles de mantener a medida que evolucionan los requerimientos de negocio. El diseño de las reglas debe priorizar los requisitos de validación más importantes y, al mismo tiempo, dejar caminos claros para mejoras futuras.
La documentación de las reglas de fórmula se vuelve especialmente importante porque estas reglas implementan una lógica de negocio que puede no ser evidente a simple vista al examinar su implementación técnica. Una documentación clara ayuda a los preparadores de los reportes a entender qué validaciones se aplicarán a sus datos y permite a quienes mantienen la taxonomía actualizar las reglas correctamente cuando cambian los requerimientos de negocio.
Plantillas de reporte XBRL (Table linkbase)
Crear formatos de presentación estructurados transforma los componentes técnicos de la taxonomía en plantillas de reporte fáciles de usar, que los preparadores pueden entender y diligenciar sin dificultad. La funcionalidad de Table linkbase permite diseñar formatos de reporte multidimensionales que reproducen las conocidas disposiciones de hoja de cálculo que se usan comúnmente en el reporte de negocio, y ofrece a los preparadores interfaces intuitivas sin perder la precisión que exige el procesamiento automatizado de los datos.
El proceso de desarrollo de la table linkbase responde a un reto fundamental del reporte digital: presentar información compleja y multidimensional en formatos que sean a la vez potentes para el análisis y accesibles en la práctica para los preparadores. Este mecanismo resulta especialmente valioso en escenarios de reporte cerrado, en los que las autoridades regulatorias, en particular los supervisores bancarios o de seguros, prescriben plantillas de reporte específicas que todas las entidades de la población que reporta deben seguir. Al definir presentaciones tabulares estandarizadas, los reguladores aseguran la consistencia en la forma como se recolecta la información y reducen la carga de aprendizaje de los preparadores, que pueden trabajar con formatos de tabla conocidos.
La arquitectura de table linkbase se integra sin fricciones con los demás componentes de la taxonomía, lo que asegura que las plantillas de presentación se mantengan sincronizadas con las reglas de validación, las relaciones de cálculo y la lógica de negocio subyacentes, definidas como estructuras dimensionales. Esta integración permite que los cambios en los requerimientos de negocio se reflejen de forma consistente tanto en la estructura analítica como en los formatos de presentación que ve el usuario, lo que asegura una alineación continua entre las necesidades regulatorias y la experiencia del preparador.
Al implementar una capa de presentación para los datos reportados, la table linkbase es uno de varios mecanismos que ofrecen las especificaciones XBRL. Este artículo explica en detalle cómo se posiciona la table linkbase frente a los demás mecanismos de presentación que ofrece el estándar XBRL.
Recursos de etiquetas
Implementar una guía de estilo de etiquetas y crear descripciones legibles por personas asegura que la taxonomía dé una orientación clara a los preparadores y mantenga la consistencia en todos los textos que ve el usuario. Las etiquetas son la interfaz principal entre la estructura técnica de la taxonomía y los usuarios de negocio que deben aplicarla a sus requerimientos de reporte.
El desarrollo de las etiquetas exige prestar mucha atención a las necesidades de las distintas comunidades de usuarios que pueden interactuar con la taxonomía. Los preparadores necesitan etiquetas que expliquen claramente qué información se debe reportar y cómo se debe calcular o determinar. Los desarrolladores de software necesitan etiquetas que faciliten la integración de sistemas y el desarrollo de interfaces de usuario. Los analistas necesitan etiquetas que apoyen la interpretación de los datos y la comparación entre distintos reportes.
Puede requerirse soporte de etiquetas en varios idiomas, según el alcance geográfico del programa de reporte y la diversidad de la comunidad de preparadores. La arquitectura de etiquetas debe acomodar varios idiomas (p. ej., el idioma local y el inglés) y mantener la consistencia del significado entre las traducciones. Este requisito agrega complejidad tanto al desarrollo inicial como a las actividades de mantenimiento continuo, pero abre las puertas al uso internacional de los datos publicados.
Referencias
Vincular los elementos con fuentes oficiales y referencias legales crea la trazabilidad que conecta cada detalle de la implementación técnica con su justificación regulatoria o de negocio. Las referencias sirven a varios públicos, entre ellos los preparadores, que necesitan entender la autoridad que respalda los requerimientos de reporte; los auditores, que deben verificar el cumplimiento, y quienes mantienen la taxonomía, que necesitan hacer seguimiento al impacto de los cambios regulatorios.
La implementación de las referencias exige un mapeo sistemático entre los elementos de la taxonomía y las disposiciones legales o regulatorias que exigen su inclusión. Este mapeo debe ser lo bastante detallado para que los usuarios puedan ubicar por sí mismos las disposiciones pertinentes y, a la vez, lo bastante conciso para que sea útil en la práctica. Los formatos de referencia deben seguir convenciones establecidas que les resulten familiares a los usuarios del dominio regulatorio correspondiente.
El mantenimiento de las referencias se vuelve especialmente importante en las taxonomías que se usarán durante periodos largos. Las disposiciones legales y regulatorias pueden modificarse, renumerarse o ser reemplazadas, lo que exige las actualizaciones correspondientes en las referencias de la taxonomía. La arquitectura de referencias debe facilitar estas actividades de mantenimiento y, a la vez, preservar la información histórica que puede necesitarse para analizar reportes anteriores.
Puntos de entrada
Organizar lógicamente la información reportada en grupos que limitan los elementos visibles les facilita a los preparadores identificar rápidamente los elementos que necesitan para tipos específicos de reporte, p. ej., trimestrales, anuales, individuales o consolidados. Los puntos de entrada funcionan como vistas personalizadas de la taxonomía que presentan solo la información pertinente para un escenario de reporte determinado, lo que reduce la complejidad y mejora la experiencia de usuario.
El diseño de los puntos de entrada exige entender los distintos tipos de preparadores que usarán la taxonomía y los diversos escenarios de reporte que enfrentan. Los puntos de entrada por sector podrían presentar solo los elementos pertinentes para instituciones bancarias, compañías de seguros o firmas de inversión. Los puntos de entrada por frecuencia podrían distinguir entre los reportes operativos mensuales y la información a revelar (divulgación) integral anual.
El mantenimiento de los puntos de entrada es una responsabilidad continua que exige coordinación entre las distintas comunidades de usuarios y sus requerimientos cambiantes. A medida que los programas de reporte maduran y cambian las necesidades de los usuarios, puede ser necesario agregar, modificar o retirar puntos de entrada. La arquitectura de los puntos de entrada debe facilitar estos cambios y, a la vez, preservar la estabilidad para los usuarios existentes.
Creación del paquete de taxonomía
Organizar una taxonomía como un conjunto de archivos conocido como paquete de taxonomía (taxonomy package) ofrece un mecanismo de distribución estandarizado que simplifica el despliegue, la gestión de versiones y las actividades de integración. Los paquetes de taxonomía reúnen todos los componentes necesarios para una taxonomía funcional en una sola unidad portátil que se puede compartir e implementar fácilmente en distintos sistemas y organizaciones.
El proceso de creación del paquete de taxonomía exige prestar mucha atención a la organización de los archivos, a la gestión de dependencias y a las consideraciones de versionamiento. Todos los archivos de esquema, los linkbases y la documentación de soporte deben incluirse en estructuras de directorios adecuadas, que faciliten el procesamiento automatizado y la inspección manual. Las dependencias de recursos externos deben identificarse y gestionarse con claridad para asegurar que los paquetes funcionen correctamente en distintos entornos de despliegue.
Aprender de las implementaciones existentes puede reducir significativamente el tiempo de desarrollo y mejorar la compatibilidad con las herramientas y los sistemas existentes. Los ejemplos de implementaciones XBRL que usan paquetes de taxonomía, como el programa ESEF en Europa, ofrecen información sobre cómo se implementa este mecanismo en cada escenario.
Paso 4: Validación y prueba del contenido técnico
La validación del contenido técnico es la fase de aseguramiento de la calidad, en la que la taxonomía terminada se somete a pruebas sistemáticas para asegurar que funcione correctamente como producto técnico e implemente fielmente los requerimientos de negocio establecidos en las fases anteriores.
El proceso de validación técnica empieza con la verificación sistemática de que la taxonomía cumple todas las especificaciones XBRL y normas técnicas pertinentes. Esta verificación de cumplimiento asegura que la taxonomía funcionará correctamente con el software estándar de procesamiento XBRL. La validación de sintaxis se centra en la corrección técnica fundamental de todos los componentes de la taxonomía: asegura que la estructura del código subyacente siga las reglas de formato adecuadas y no contenga errores estructurales que impidan que el software de procesamiento interprete correctamente la taxonomía. Este nivel de validación detecta errores técnicos básicos que podrían volver inutilizable toda la taxonomía, como estructuras de archivo mal formadas, referencias incorrectas entre componentes o incumplimientos de los requisitos de formato XML. Aunque los errores de sintaxis son la categoría más básica de problemas técnicos, pueden tener efectos devastadores en el despliegue de la taxonomía si no se identifican y corrigen durante la fase de validación.
Otra área de verificación técnica es la validación del paquete, que incluye procedimientos de prueba para asegurar que los paquetes distribuidos funcionen correctamente en distintos escenarios de despliegue y plataformas de software. La validación debe cubrir tanto el cumplimiento técnico de las normas de empaquetado como las pruebas funcionales con datos y casos de uso representativos.
Las pruebas de desempeño evalúan cómo se comporta la taxonomía en condiciones de operación realistas, y valoran factores como los tiempos de carga, los requisitos de memoria y la eficiencia de procesamiento, que afectarán la experiencia práctica de los preparadores y de los receptores. Una taxonomía que funciona correctamente pero tiene un desempeño deficiente puede crear barreras para la adopción o imponer costos significativos a los usuarios, que deben invertir en recursos de cómputo adicionales para lograr un desempeño aceptable. La validación del desempeño suele consistir en probar la taxonomía con volúmenes de datos representativos y patrones de uso realistas, para identificar posibles cuellos de botella o limitaciones de recursos que puedan afectar el éxito del despliegue.
La fase de validación técnica concluye cuando la taxonomía ha demostrado un desempeño confiable en todos los casos de uso y condiciones de operación previstos. En ese punto, los representantes de los reguladores pueden confiar en que la implementación técnica apoyará con eficacia sus objetivos de política y dará a los preparadores una herramienta confiable para cumplir sus obligaciones de reporte. La rigurosidad y la precisión de la validación técnica influyen directamente en el éxito de las fases posteriores de despliegue y adopción, lo que hace de este paso un factor crítico de la eficacia general del programa.
Paso 5: Validación y prueba del contenido de negocio
La validación del contenido de negocio es la fase de prueba crucial en la que la taxonomía terminada demuestra su capacidad para capturar y procesar con eficacia escenarios de reporte del mundo real. Durante este proceso se verifica si todos los componentes técnicos funcionan juntos sin fricciones para soportar actividades de reporte reales en condiciones realistas. Esta fase cierra la brecha entre la corrección técnica y la utilidad práctica, y asegura que la taxonomía cumpla el propósito para el que fue creada cuando se despliegue en el entorno regulatorio.
Esta fase de validación responde a una pregunta fundamental que los representantes de los reguladores deben contestar antes de lanzar su programa de reporte: ¿funciona la taxonomía para preparadores reales que enfrentan situaciones de negocio reales? La validación técnica confirma que la taxonomía cumple los requisitos de la especificación, pero la validación del contenido de negocio demuestra si esas especificaciones técnicamente correctas se traducen en un sistema de reporte funcional que captura la información necesaria para el análisis regulatorio y la implementación de las políticas.
El proceso de validación de negocio empieza con la creación de reportes de muestra usando, en la medida de lo posible, datos reales que sean representativos de los preparadores de reportes que caen dentro del alcance del programa de reporte. Esta creación de reportes de muestra sirve para varios propósitos más allá de la simple prueba de funcionalidad. Revela cómo vivirán los preparadores la experiencia con la taxonomía al trabajar con su propia información, identifica retos prácticos que pueden no haber sido evidentes durante el diseño conceptual y demuestra si la estructura de la taxonomía se alinea con los flujos naturales de información del negocio.
Crear reportes de muestra suele dejar al descubierto vacíos o ambigüedades en el diseño de la taxonomía que no eran evidentes en las fases anteriores de desarrollo. La información de negocio rara vez encaja perfectamente en las categorías ordenadas que sugieren los modelos conceptuales, y los preparadores con frecuencia se encuentran con casos límite, excepciones y circunstancias inusuales que ponen a prueba los enfoques de reporte estándar. Estos hallazgos durante la validación de negocio son oportunidades para refinar el diseño de la taxonomía antes del despliegue, resolviendo problemas prácticos cuando las correcciones todavía son relativamente sencillas y no después de que una adopción generalizada haya hecho los cambios más disruptivos.
La validación de las reglas de cálculo y de las basadas en fórmulas se centra en probar las relaciones matemáticas y lógicas incorporadas en la taxonomía frente a escenarios de datos realistas. Este proceso de prueba verifica que las reglas de validación funcionen correctamente con datos de negocio reales e identifica situaciones en las que las reglas pueden ser demasiado restrictivas, demasiado permisivas o inadecuadas para circunstancias de negocio legítimas.
Las pruebas de completitud verifican de forma sistemática que la taxonomía capture toda la información requerida para soportar el análisis regulatorio y los objetivos de política que motivaron el programa de reporte. Este proceso de prueba suele revelar vacíos sutiles, en los que información importante queda entre las categorías de reporte definidas o en los que el nivel de detalle que ofrece la taxonomía resulta insuficiente para los fines analíticos previstos.
Las pruebas de casos límite exploran cómo se comporta la taxonomía frente a escenarios de datos inusuales, de frontera o extremos que quedan por fuera de las operaciones normales del negocio. Este proceso de prueba ayuda a identificar situaciones en las que la taxonomía puede producir resultados inesperados, no validar correctamente o arrojar resultados analíticos engañosos. Los casos límite suelen revelar supuestos incorporados en el diseño de la taxonomía que pueden no cumplirse en todas las circunstancias, lo que brinda oportunidades para fortalecer la solidez general del sistema de reporte.
La fase de validación del contenido de negocio concluye cuando la taxonomía ha demostrado un desempeño confiable en escenarios representativos del mundo real, una cobertura completa de la información requerida y un manejo sólido de las circunstancias excepcionales. En ese punto, los representantes de los reguladores pueden avanzar con confianza hacia las fases de consulta pública y despliegue, sabiendo que la taxonomía se ha probado a fondo en condiciones realistas y ha demostrado que puede soportar con eficacia los objetivos regulatorios para los que fue creada.
El último paso del proceso de desarrollo de la taxonomía es la preparación de la documentación correspondiente de la taxonomía y la publicación de los artefactos creados.
Lea más sobre la publicación de taxonomías en este artículo.
Un proceso de desarrollo iterativo y guiado por el negocio
Aunque pueda parecer técnico, el proceso de desarrollo de una taxonomía es un ejercicio principalmente orientado al negocio, en el que los expertos en política regulatoria y los usuarios de los datos cumplen papeles clave. El producto final —una taxonomía XBRL— es un artefacto técnico que, además de los requerimientos de negocio, también atiende necesidades técnicas.
El desarrollo de una taxonomía no es un ejercicio de una sola vez, sino un proceso iterativo en el que el modelo de datos y, después, la taxonomía XBRL se modifican como resultado de pequeños ciclos de prueba que validan la conformidad con las especificaciones XML y XBRL y con las mejores prácticas. Mientras que los requerimientos formales y las reglas de modelado son componentes estables del proceso de la taxonomía, el modelo de datos y la taxonomía pueden pasar por múltiples modificaciones antes de convertirse en artefactos finales.
Factores de plazo y duración en el desarrollo de una taxonomía
Desarrollar una taxonomía no es un proceso único que sirva para todos los casos. El plazo puede variar ampliamente según varios factores:
- El alcance y la complejidad del marco legal.
- La extensión de las reglas de validación.
- Las oportunidades de reutilizar taxonomías existentes.
- El ritmo de desarrollo de la experiencia local.
- La rigurosidad del gobierno y de los ciclos de revisión.
Cada una de estas dimensiones determina directamente qué tan rápido se puede finalizar una versión inicial. En promedio, la mayoría de los proyectos toman de seis a nueve meses, pero la duración real varía significativamente según el alcance, la alineación y los procesos con los grupos de interés.
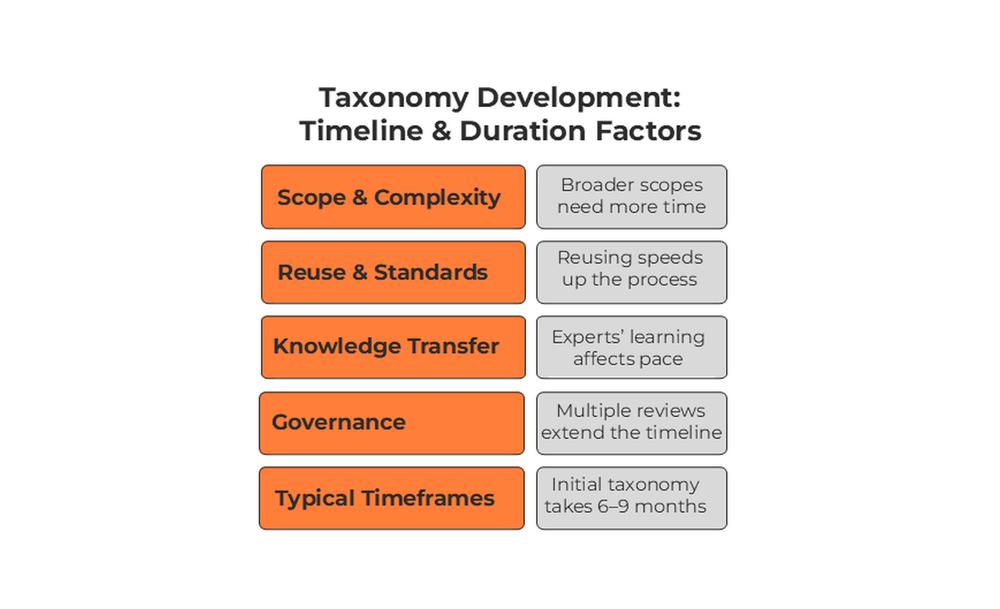
Alcance y complejidad del marco legal
El tiempo necesario para desarrollar una versión inicial de la taxonomía depende fundamentalmente del alcance y la complejidad del marco legal subyacente que la taxonomía debe representar. Los requisitos de política suelen redactarse sin considerar su futura traducción a modelos de datos estructurados, lo que con frecuencia implica tiempo adicional para aclarar y resolver inconsistencias en las definiciones de los conceptos o requisitos contradictorios que surgen durante el desarrollo del modelo de datos.
Cuando el modelo de datos se desarrolla en paralelo con la redacción final de la política, el plazo combinado de ambas tareas puede ser más corto que en los escenarios en los que el modelo de datos se desarrolla como un paso posterior al establecimiento de la política. Este enfoque en paralelo permite un refinamiento iterativo: quienes redactan la política pueden considerar las implicaciones de sus requisitos para el reporte estructurado, mientras que quienes desarrollan la taxonomía pueden identificar posibles retos de implementación antes de que las políticas queden fijas.
El alcance y la complejidad del marco subyacente se reflejan significativamente en el número y la complejidad de las verificaciones de calidad de los datos que deben convertirse en reglas de validación. Un mayor número de requisitos de validación complejos exige proporcionalmente más tiempo para implementarlos y probarlos adecuadamente, porque cada regla debe especificarse con precisión, codificarse y verificarse frente a diversos escenarios de datos.
Oportunidades de reutilización de taxonomías y estándares existentes
Un segundo factor que influye sustancialmente en la duración del desarrollo es si el marco de política subyacente permite reutilizar taxonomías o componentes existentes. Cuando los marcos de política se alinean estrechamente con taxonomías ya establecidas, reutilizarlas puede acortar significativamente el tiempo necesario para desarrollar la taxonomía objetivo. Esta reutilización puede consistir en adoptar secciones completas de la taxonomía, adaptar conceptos existentes a los requisitos locales o usar patrones establecidos para estructurar tipos de información similares.
El grado de alineación entre los requisitos locales y los estándares internacionales afecta tanto el alcance de la reutilización posible como la complejidad de las adaptaciones necesarias. Los marcos que siguen de cerca estándares internacionales, como las IFRS o los requisitos de Basilea, pueden aprovechar una cantidad sustancial de trabajo existente, mientras que los requisitos muy específicos de una jurisdicción pueden exigir un mayor esfuerzo de desarrollo propio.
Transferencia de conocimiento y desarrollo de la experiencia local
El tercer factor crítico es la transferencia de conocimiento y el desarrollo de la experiencia local. Incluso cuando se contratan expertos externos con varios años de experiencia en desarrollo de taxonomías, el tiempo necesario para desarrollar la taxonomía objetivo depende significativamente de qué tan rápido los expertos locales aprendan el proceso de desarrollo y tomen decisiones oportunas sobre los aspectos del modelo de datos y del desarrollo de la taxonomía que planteen los consultores externos.
Esta necesidad de aprendizaje existe porque los expertos externos, a pesar de su dominio técnico, no tienen un conocimiento y una comprensión completos de los requisitos de reporte locales, del contexto regulatorio y de las prioridades institucionales. Por eso, los expertos locales deben desarrollar una comprensión suficiente de los principios de desarrollo de taxonomías para tomar decisiones informadas sobre compromisos, prioridades y enfoques de implementación alineados con los objetivos regulatorios nacionales.
Procesos de gobierno y revisión
El número de rondas de revisión de gobierno afecta significativamente los plazos de desarrollo: múltiples ciclos de revisión internos, externos y con los grupos de interés extienden el proceso de finalización. Cada ronda de revisión suele implicar recopilar retroalimentación, analizar los cambios sugeridos, hacer las modificaciones necesarias y entregar una nueva versión de la taxonomía para la revisión siguiente. La complejidad de este proceso aumenta cuando varios grupos de interés tienen prioridades distintas o cuando los ciclos de revisión revelan problemas de fondo que exigen revisiones sustanciales.
Unas estructuras de gobierno eficaces pueden acelerar este proceso al establecer instancias de decisión claras, definir criterios de revisión específicos y crear mecanismos para resolver conflictos entre los requisitos de distintos grupos de interés. Sin embargo, los procesos de revisión rigurosos siguen siendo esenciales para asegurar que las taxonomías cumplan sus propósitos y obtengan la aceptación necesaria de los grupos de interés.
Plazos típicos de desarrollo
Normalmente, desarrollar una versión inicial de una taxonomía toma de seis a nueve meses, aunque este plazo puede variar significativamente según los factores descritos arriba. Las taxonomías sencillas que reutilizan una cantidad sustancial de componentes existentes y atienden requisitos de política sencillos pueden completarse más rápido, mientras que los marcos complejos que abordan requisitos regulatorios novedosos con reglas de validación extensas pueden requerir periodos de desarrollo más largos.
Este periodo se refiere únicamente a la primera versión de la taxonomía pública y no incluye el tiempo necesario para desarrollar una plataforma tecnológica para la generación de reportes XBRL, su validación y su recolección. Tampoco cubre la realización de pruebas piloto con los grupos de interés, que se hacen una vez la taxonomía está disponible públicamente.
Resumen
El proceso de desarrollo de una taxonomía es un enfoque sistemático para crear marcos de reporte digital estructurado que sirvan tanto a los objetivos regulatorios como a las necesidades prácticas de implementación. Este proceso integral transforma los requisitos de política en taxonomías XBRL funcionales a través de cinco fases distintas pero interconectadas, cada una construida sobre la anterior, para asegurar tanto el cumplimiento técnico como la utilidad para el negocio.
A lo largo de este proceso, el desarrollo de la taxonomía sigue siendo fundamentalmente un ejercicio guiado por el negocio, en el que los especialistas en política regulatoria y los usuarios de los datos cumplen papeles centrales. La naturaleza iterativa del desarrollo asegura que tanto los requerimientos de negocio como las restricciones técnicas se atiendan mediante ciclos sucesivos de refinamiento. El éxito depende no solo de la corrección técnica, sino también de qué tan bien la taxonomía final atiende las necesidades prácticas de los preparadores y apoya los objetivos analíticos de los receptores de datos y de quienes formulan las políticas.
El enfoque sistemático descrito en esta visión general del proceso ofrece a los representantes de los reguladores un marco para gestionar con eficacia proyectos complejos de desarrollo de taxonomías. Al entender cada fase y su contribución al objetivo general, los reguladores pueden ejercer una supervisión adecuada y, al mismo tiempo, asegurar que sus programas de reporte digital logren sus objetivos de política de manera eficiente y sostenible.
Texto original en inglés: https://playbook.xbrl.org/