Inicio › Capítulos › Capítulo 6 · Recolección, almacenamiento y análisis de datos
6.3 · Almacenamiento, protección y republicación de reportes XBRL
33 min de lectura
6.3 · Almacenamiento, protección y republicación de reportes XBRL
Objetivos de aprendizaje
- Comprender los roles ampliados que asumen los supervisores al implementar sistemas de reporte digital, incluidas las responsabilidades de receptor, custodio y publicador de datos.
- Identificar las consideraciones para diseñar sistemas de almacenamiento que se ajusten a las características de los datos XBRL, a los requisitos legales y a los casos de uso previstos.
- Evaluar enfoques técnicos de almacenamiento, como los sistemas basados en archivos, las bases de datos relacionales y las soluciones híbridas, para distintos contextos regulatorios.
- Planear la adaptabilidad del sistema para acomodar taxonomías en evolución y requisitos regulatorios cambiantes.
- Implementar medidas de seguridad adecuadas, que equilibren las necesidades de acceso de los grupos de interés con los requisitos de protección de los datos.
- Diseñar estrategias de publicación que sirvan a los objetivos de transparencia y, al mismo tiempo, mantengan la confidencialidad cuando se requiera.
- Seleccionar mecanismos adecuados de distribución de datos, como la visualización a la medida, la visualización (renderizado) de iXBRL, las descargas por lotes y el acceso mediante API.
Introducción
Después de recoger con éxito los reportes digitales de negocio, los supervisores deben resolver cómo almacenar, proteger y, si la regulación lo permite, republicar estos datos.
Las decisiones que tomen los receptores de datos sobre el almacenamiento, la seguridad y la publicación de los datos determinarán qué tan bien sirve la información recogida a la supervisión regulatoria, a la transparencia pública y al análisis del mercado. Hay varias consideraciones técnicas y de política clave para gestionar los datos XBRL después de su recolección.
Los roles de los supervisores: de receptor a publicador de datos
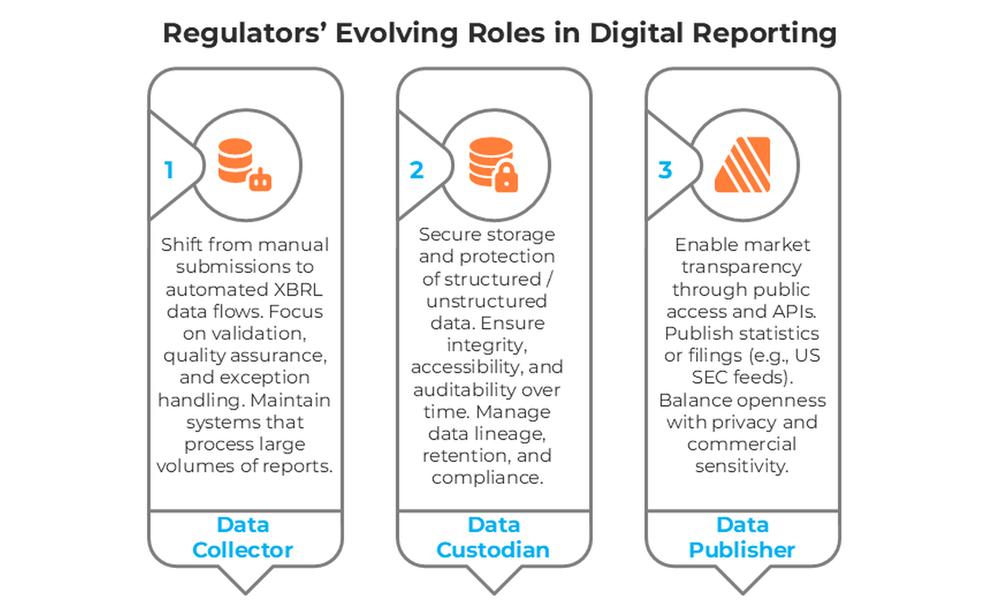
Al planear la implementación de un programa de reporte digital, los supervisores deberían reconocer que, una vez el sistema entra en operación y los datos empiezan a fluir, sus responsabilidades van mucho más allá de la tradicional definición de políticas. El paso de definir los requisitos de reporte a gestionar flujos de datos en vivo introduce tres roles distintos pero interconectados, que transforman de fondo la manera como operan los supervisores.
Receptor de datos
La primera evolución tiene que ver con el rol ampliado del supervisor como receptor de datos. Aunque los supervisores tienen una larga trayectoria recogiendo información de las entidades vigiladas, el reporte digital habilitado por XBRL transforma este proceso manual en un flujo de datos automatizado. Este cambio exige que los supervisores desarrollen nuevas capacidades en validación de datos, aseguramiento de la calidad y manejo de excepciones. El receptor debe asegurar que los reportes XBRL que llegan cumplan tanto las reglas técnicas de reporte (filing rules) como las reglas de validación de negocio, y a la vez mantener los sistemas operativos que procesan potencialmente miles de reportes en distintos ciclos de reporte.
Lea sobre la recepción y visualización de reportes XBRL en este artículo.
Custodio de datos
El segundo rol es el de custodio de datos. En la era de la digitalización y de los riesgos de ciberataques, la recolección de información digital trae responsabilidades adicionales para los supervisores: asegurar el almacenamiento seguro, la integridad y la conservación de enormes cantidades de datos de negocio estructurados y no estructurados. Esta custodia va más allá de una simple bodega de datos (data warehouse): incluye asegurar que los datos sigan siendo accesibles e interpretables con el tiempo y, en el caso de los reportes basados en XBRL, aun cuando las taxonomías XBRL evolucionen y cambien los requisitos de reporte. El rol de custodio también abarca mantener los registros de auditoría (audit trails), gestionar el linaje de los datos y proteger la información sensible, asegurando al mismo tiempo el cumplimiento de las normas de protección de datos.
Publicador de datos
El tercer rol, y a menudo el más transformador, es el de publicador de datos. Muchos supervisores encuentran que la naturaleza marcada de los datos XBRL crea oportunidades, y a veces obligaciones, de mejorar la transparencia del mercado mediante la publicación de datos. Esto puede implicar publicar estadísticas agregadas del mercado, permitir el acceso público a los reportes de cada entidad o proveer canales de datos (data feeds) para que los usuarios reciban alertas automáticas cuando se publique nueva información, como los nuevos reportes ante la SEC de EE. UU.. Los datos XBRL publicados cobran especial importancia en el contexto de las herramientas emergentes de IA que pueden analizar el contenido numérico y descriptivo de los reportes XBRL. El rol de publicador exige que los supervisores equilibren los objetivos de transparencia con la sensibilidad comercial y las preocupaciones de privacidad.
Estos roles en evolución influyen de manera importante en la toma de decisiones técnicas a lo largo del programa de reporte digital. Por ejemplo, las responsabilidades de custodio de datos impulsan los requisitos de arquitecturas de almacenamiento de datos seguras y robustas, de políticas de mantenimiento y de sistemas de copias de respaldo. El rol de publicador influye en las decisiones sobre los formatos de datos, las API públicas y el diseño de la interfaz de usuario. (Un ejemplo de este tipo de API es la página web de reportes de XBRL International, donde los usuarios pueden seleccionar y descargar manualmente un reporte NIIF determinado o usar una API para automatizar la obtención de los reportes). La función ampliada de receptor afecta las decisiones sobre la implementación de las reglas de validación y los enfoques de integración de sistemas.
Almacenamiento de la información a revelar digital
Antes de implementar soluciones técnicas de almacenamiento, los supervisores deben entender las características y los requisitos de los datos que van a recoger. Este entendimiento orienta todas las decisiones técnicas posteriores sobre cómo almacenar, proteger y gestionar el acceso a la información a revelar (divulgación) en formato digital.
Entender la naturaleza de los datos recogidos
El tipo de información que recoge un receptor de datos determina de fondo su enfoque de almacenamiento. La información a revelar digital abarca un amplio espectro, desde reportes periódicos, como los estados financieros y los reportes de supervisión, hasta datos transaccionales de alta frecuencia que se recogen a diario. Cada tipo plantea retos y oportunidades distintos para el diseño del almacenamiento.
Los reportes digitales de negocio suelen contener tanto datos financieros estructurados como información de soporte. Los datos marcados en detalle siguen el formato de la taxonomía, mientras que los documentos de soporte pueden incluir informes de auditoría, resoluciones de la junta directiva o notas explicativas que recogen un contenido informativo más amplio usando una marca XBRL determinada. Esta doble naturaleza implica que el sistema de almacenamiento debería prever el manejo de datos legibles por máquina tanto con herramientas analíticas tradicionales para datos estructurados como con herramientas modernas basadas en IA para texto no estructurado, y cada una requiere enfoques de almacenamiento de datos distintos.
Las consideraciones de volumen van más allá de simplemente contar archivos. El número de entidades que reportan afecta las necesidades totales de almacenamiento, pero la frecuencia de envío crea patrones que influyen en el diseño del sistema. Parte de la información a revelar, en particular la que recogen los supervisores financieros, puede ser de tamaño considerable. Los reportes bancarios pueden contener desgloses detallados de las carteras de crédito o de las inversiones, con miles de datos individuales. De manera similar, los reportes de seguros pueden incluir información completa a nivel de póliza en múltiples líneas de producto.
Entender estos patrones de volumen ayuda a los supervisores a planear los periodos pico, cuando muchas entidades envían al mismo tiempo, como en las fechas límite del reporte trimestral. En un escenario así, el sistema de almacenamiento debe manejar estos picos sin comprometer el desempeño ni la accesibilidad.
Consideraciones legales y regulatorias
Los sistemas de almacenamiento deben cumplir requisitos legales que varían mucho entre jurisdicciones. Estos requisitos influyen directamente en las opciones técnicas de los supervisores y pueden descartar por completo ciertos enfoques. En particular, las restricciones de soberanía de datos pueden limitar dónde se puede almacenar la información. Algunas jurisdicciones prohíben almacenar datos financieros o personales sensibles fuera de las fronteras nacionales, lo que afecta las opciones de almacenamiento en la nube. Otras exigen que las entidades del gobierno mantengan el control directo sobre la infraestructura de almacenamiento, lo que excluye ciertas soluciones de terceros.
Los periodos de conservación son una consideración fundamental. Algunas jurisdicciones exigen conservar los datos financieros durante siete años, mientras que otras imponen periodos más largos para ciertos tipos de información. Estos requisitos afectan no solo la planeación de la capacidad de almacenamiento, sino también las estrategias de migración de datos a medida que evoluciona la tecnología.
Las normas de admisibilidad legal determinan cómo debe conservar un supervisor los documentos. Los tribunales pueden exigir que los documentos almacenados mantengan su forma original y demuestren una cadena de custodia ininterrumpida. Este requisito suele imponer controles de integridad específicos, como firmas digitales o mecanismos de almacenamiento que evidencien cualquier manipulación.
Uso previsto de los datos almacenados
Los distintos usos previstos generan requisitos de almacenamiento diferentes, que deben considerarse desde el principio. Cada caso de uso trae requisitos específicos de desempeño, acceso y formato que moldean las decisiones técnicas.
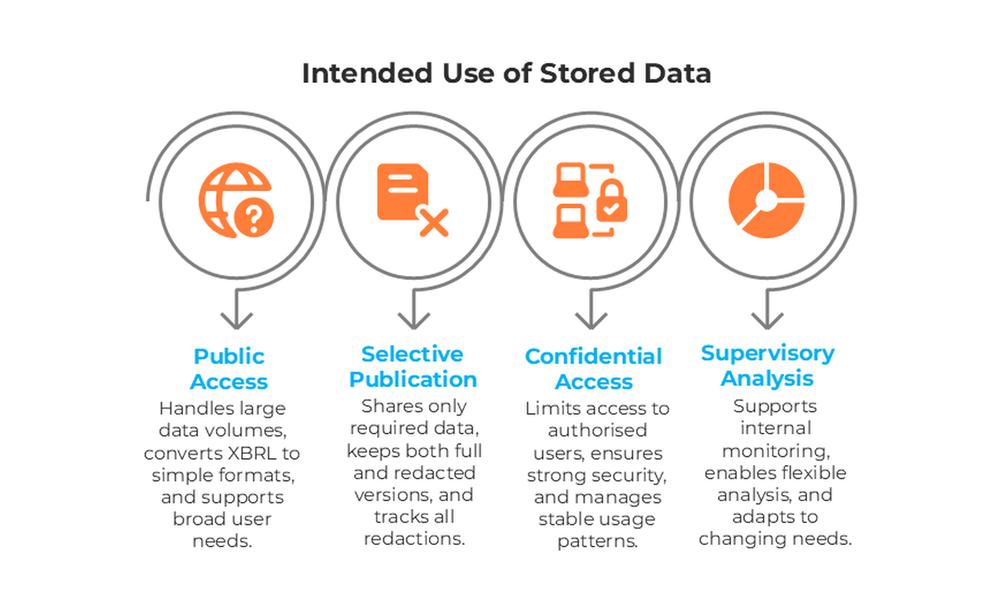
- Acceso público: es el caso de uso más complejo, porque combina un alto volumen con necesidades de usuario diversas. Los reportes recogidos que se ponen a disposición del público con frecuencia requieren conversión de formato, por ejemplo a xBRL-JSON o a archivos CSV. En el caso de XBRL, la necesidad de conversión surge de que este estándar técnico sirve principalmente para el intercambio y la validación de datos, más que para el consumo humano. La tecnología es excelente para asegurar la integridad y la corrección de los datos mediante los mecanismos de validación incorporados en las taxonomías, pero los usuarios que analizan los datos suelen preferir formatos más accesibles que el propio XBRL.
- Publicación selectiva (p. ej., datos agregados o anonimizados): crea una complejidad adicional, porque exige mantener versiones completas y versiones depuradas de la misma información. Los reportes que contienen información sensible, como los salarios individuales o información de negocio confidencial, deben depurarse cuidadosamente antes de su divulgación pública. El sistema de almacenamiento de un receptor de datos puede requerir mecanismos adicionales de seguimiento para identificar qué elementos deben suprimirse y mantener registros de auditoría que muestren qué información se retiró y por qué.
- Acceso confidencial: se aplica a los reportes disponibles solo para usuarios autorizados, como el personal de supervisión que revisa los reportes de los sectores bancario y asegurador, o las operaciones diarias realizadas en el mercado mostrador (over-the-counter) o en una bolsa determinada. Estos casos de uso suelen requerir los niveles de seguridad más altos, pero sirven a poblaciones de usuarios más pequeñas, con patrones de acceso predecibles.
- Análisis de supervisión: abarca el uso regulatorio interno para la vigilancia y el seguimiento del mercado. Este caso de uso suele requerir capacidades de consulta sofisticadas y puede implicar combinar datos de múltiples periodos de reporte o entidades para identificar tendencias y riesgos. Los requisitos analíticos pueden cambiar con frecuencia, lo que exige mantener una solución que permita implementar con relativa rapidez nuevas funciones de búsqueda, análisis y presentación, según los requisitos más recientes que definan los usuarios internos de los datos.
Enfoques técnicos de almacenamiento
Con los requisitos claros, los supervisores pueden evaluar las soluciones técnicas adecuadas. Cada enfoque ofrece ventajas y limitaciones distintas, que se ajustan a casos de uso específicos.
Las decisiones sobre la infraestructura de almacenamiento pueden determinar de fondo el enfoque de implementación técnica. Las soluciones en las instalaciones propias (on-premises) dan el máximo control y pueden ser necesarias en jurisdicciones con requisitos estrictos de soberanía de datos. Las soluciones en nube privada ofrecen beneficios de escalabilidad y mantienen el control sobre la ubicación de los datos y el acceso a ellos. Las soluciones híbridas combinan el almacenamiento en las instalaciones propias para los datos sensibles con recursos en la nube para la información pública o para la capacidad de procesamiento.
Las decisiones sobre el formato de almacenamiento afectan tanto el desempeño como la funcionalidad. Al diseñar un mecanismo de almacenamiento de datos, pueden considerarse las siguientes opciones:
- Almacenamiento basado en archivos, para conservar los documentos en su forma original, lo que soporta los requisitos de admisibilidad legal y mantiene registros de auditoría completos.
- Bases de datos relacionales, que permiten consultas sofisticadas sobre los elementos de datos estructurados, pero pueden requerir extraer los datos de los formatos originales de reporte.
- Bases de datos vectoriales, para soportar el análisis basado en grandes modelos de lenguaje de la información descriptiva o narrativa enviada en los reportes de negocio.
En el caso del reporte basado en XBRL, al implementar el almacenamiento basado en archivos para los reportes XBRL, hay dos consideraciones técnicas que pueden mejorar de forma importante los resultados de eficiencia y de seguridad.
La primera es la compresión de archivos, que ofrece grandes beneficios de almacenamiento porque los documentos XBRL contienen cantidades importantes de texto estructurado repetitivo y de formato XML. Los archivos XBRL comprimidos suelen requerir una fracción del espacio de almacenamiento de sus versiones sin comprimir, sin ninguna pérdida de integridad de los datos. Esta reducción resulta especialmente valiosa al almacenar grandes volúmenes de reportes durante periodos de conservación prolongados. Los formatos de compresión estándar, como ZIP, mantienen la posibilidad de validar y procesar los archivos XBRL y reducen de manera notable los costos de almacenamiento y los tiempos de las copias de respaldo.
La segunda es el cifrado a nivel de archivo, que aporta una capa adicional de seguridad esencial para los documentos XBRL almacenados. Aun cuando existan medidas de seguridad más amplias en el sistema, cifrar cada archivo asegura que un acceso no autorizado a la infraestructura de almacenamiento no pueda comprometer el contenido real de los reportes. Este enfoque protege tanto frente a brechas de seguridad externas como frente a un posible mal uso interno del acceso al sistema. El cifrado de archivos debería usar estándares de cifrado robustos e integrarse con el sistema general de gestión de claves, para mantener la accesibilidad de largo plazo sin perder seguridad.
Estos enfoques técnicos funcionan bien juntos, ya que la compresión puede aplicarse antes del cifrado sin comprometer ni la seguridad ni la eficiencia en el uso del espacio. El enfoque combinado de almacenamiento de archivos comprimidos y cifrados ofrece tanto eficiencia operativa como una protección robusta de los datos para los repositorios de documentos XBRL. Además, los reportes XBRL basados en archivos pueden almacenarse siguiendo una convención de nombres de archivo que indique explícitamente la taxonomía XBRL a la que corresponde el reporte.
Una última consideración al diseñar los enfoques de almacenamiento es planear cuidadosamente la escalabilidad del sistema, lo que asegurará que la solución final crezca de manera efectiva con los requisitos cambiantes. Esta planeación abarca no solo la capacidad de almacenamiento, sino también la capacidad de procesamiento para la conversión de datos, el desempeño de las consultas para el análisis y la capacidad de red para el acceso público. Los sistemas deben acomodar volúmenes crecientes de información a revelar sin requerir cambios de arquitectura de fondo que puedan interrumpir las operaciones.
Adaptabilidad del sistema
Los sistemas de almacenamiento deben evolucionar junto con los requisitos regulatorios y las normas de reporte. Este requisito de adaptabilidad afecta tanto la arquitectura técnica como los procedimientos operativos.
El versionamiento de las taxonomías crea retos permanentes, porque distintos periodos de reporte pueden usar distintas versiones de la taxonomía. Por lo tanto, un sistema de almacenamiento debe mantener las relaciones entre las versiones y asegurar la comparabilidad de los datos entre periodos. Algunas entidades pueden reportar tarde usando versiones anteriores de la taxonomía, lo que exige que el sistema soporte varias versiones al mismo tiempo.
Los elementos de extensión de las empresas agregan complejidad, porque las entidades pueden definir datos a la medida que no están incluidos en las taxonomías estándar. El sistema de almacenamiento debe acomodar estas extensiones y mantener la posibilidad de buscar y analizar datos entre entidades. Cuando las extensiones están ancladas a conceptos de la taxonomía base, el sistema de almacenamiento debería conservar estas relaciones de forma estructurada, para que sigan disponibles para el análisis y apoyen la comparabilidad.
A medida que evolucionan los requisitos regulatorios, pueden surgir puntos de entrada o taxonomías específicos por sector. Los supervisores bancarios podrían desarrollar taxonomías especializadas para distintos tipos de instituciones, mientras que los reguladores de valores podrían crear requisitos de reporte específicos por industria. La arquitectura de almacenamiento debe acomodar estos desarrollos sin exigir un rediseño completo del sistema.
Esta adaptabilidad asegura la estabilidad del sistema y, al mismo tiempo, hace posible la innovación regulatoria. Al planear para el cambio desde el principio, los supervisores pueden implementar soluciones de almacenamiento que sirvan a las necesidades actuales y, a la vez, soporten los desarrollos futuros de los requisitos de reporte digital. Esta adaptabilidad se vuelve especialmente crítica al implementar almacenamiento en bases de datos relacionales para el contenido XBRL. En este caso, la arquitectura de la base de datos debe acomodar tanto los datos reportados como las estructuras de la taxonomía subyacente, que definen el significado de los datos y otros metadatos. Esta doble consideración exige una planeación cuidadosa del diseño para asegurar la estabilidad del sistema en el largo plazo.
Una arquitectura de base de datos que tenga en cuenta la taxonomía debe reflejar la naturaleza jerárquica e interconectada de las taxonomías XBRL, en lugar de simplemente almacenar tablas de datos planas. La estructura de la base de datos debería capturar las definiciones de los conceptos, las relaciones entre los elementos de datos, las reglas de cálculo y las jerarquías de presentación que existen dentro de las taxonomías. Este enfoque permite al sistema validar la integridad de los datos, mantener el significado semántico entre distintos periodos de reporte y soportar consultas sofisticadas que aprovechan las relaciones de la taxonomía.
El almacenamiento de datos independiente de la versión puede lograrse mediante enfoques basados en metadatos, en los que la estructura de la base de datos se mantiene constante y la información específica de cada taxonomía se almacena como metadatos configurables. Las nuevas versiones de la taxonomía introducen nuevas configuraciones de metadatos, y no nuevas tablas o columnas en la base de datos. Este enfoque asegura que los datos históricos sigan siendo accesibles y comparables aun cuando evolucionen los requisitos de reporte, mientras que los nuevos elementos de datos se integran sin tropiezos en la infraestructura existente.
Un diseño efectivo de base de datos relacional para XBRL exige equilibrar las necesidades inmediatas de almacenamiento con los requisitos de adaptabilidad de largo plazo, para que las decisiones técnicas de hoy soporten los desarrollos regulatorios de mañana.
Protección de la información a revelar digital
Los requisitos de seguridad de la información a revelar digital dependen de quién necesita acceder a los datos y con qué propósito. Entender estos patrones de acceso ayuda a los supervisores a diseñar accesos por perfiles y medidas de seguridad adecuadas, que protejan la información sensible y permitan su uso legítimo.
Identificación de los requisitos de acceso a los datos
Los distintos grupos de interés requieren distintos niveles de acceso a la información a revelar almacenada, según sus roles e intereses legítimos. Entender estos patrones de acceso permite a los supervisores diseñar marcos de seguridad adecuados que sirvan a las necesidades legítimas y protejan la información sensible.
Acceso público
El público en general y los participantes del mercado requieren acceso a la información a revelar por razones de transparencia y para tomar decisiones de inversión informadas. Esta amplia categoría incluye a los inversionistas individuales, a los gestores de fondos institucionales y a otros usuarios de datos que dependen de la información que revelan las empresas para evaluar oportunidades y riesgos relacionados con inversiones o con otras actividades, como otorgar créditos o firmar acuerdos comerciales para el suministro de productos o servicios.
Los investigadores y analistas que realizan estudios de mercado y análisis comparativos son otro grupo de usuarios importante. Las instituciones académicas, los centros de pensamiento (think tanks) y las organizaciones comerciales de investigación con frecuencia requieren acceso a series de datos históricas y a conjuntos de datos transversales para identificar tendencias y realizar estudios empíricos.
Los medios de comunicación y los grupos de la sociedad civil necesitan acceso con fines de veeduría y de información al público. Los periodistas que investigan la conducta empresarial o las tendencias económicas requieren acceso con búsqueda a los datos de los reportes, mientras que las organizaciones de incidencia que vigilan el comportamiento empresarial necesitan información completa de lo revelado.
Acceso regulatorio interno
El personal de supervisión requiere acceso permanente para vigilar el cumplimiento y evaluar los riesgos específicos de cada entidad. Este acceso suele abarcar tanto los reportes actuales como los datos históricos, para identificar tendencias, valores atípicos y posibles inquietudes que requieran una investigación más a fondo.
Los equipos de cumplimiento coercitivo (enforcement) necesitan un acceso completo durante los procedimientos de investigación. Esto puede incluir no solo la información a revelar reportada, sino también la documentación de soporte y los registros de auditoría que muestran el historial de reportes, las correcciones y la correspondencia relacionada.
Los equipos de política que realizan análisis de impacto regulatorio y desarrollo normativo requieren acceso agregado a múltiples entidades y periodos. Este acceso apoya la formulación de políticas basada en evidencia, al permitir analizar la carga del reporte, las tendencias de calidad de los datos y la evolución del mercado.
La alta dirección requiere información de vigilancia estratégica, normalmente en formatos resumidos o de tablero (dashboard) que resalten las tendencias clave, los patrones de cumplimiento y los riesgos emergentes en la población vigilada.
Acceso controlado
El acceso de las entidades que reportan a sus propios datos enviados es un requisito de acceso fundamental. Las empresas necesitan verificar sus reportes, corregir errores cuando esté permitido y recuperar envíos históricos para análisis internos o con fines de auditoría.
Los agentes autorizados que actúan en nombre de las entidades que reportan requieren derechos de acceso similares, dentro de parámetros definidos. Las firmas de contabilidad, los asesores legales y los proveedores de servicios de software pueden necesitar acceso para apoyar las obligaciones de reporte de sus clientes o sus actividades de cumplimiento permanentes.
Otros organismos reguladores que operan bajo acuerdos de intercambio de información requieren un acceso cuidadosamente definido a las partes pertinentes de los datos. Los reguladores de valores pueden compartir información con los supervisores bancarios, las autoridades tributarias o sus contrapartes internacionales en virtud de acuerdos formales.
Los auditores externos que realizan exámenes regulatorios o auditorías de entidades requieren acceso a los datos de entidades específicas dentro de periodos definidos y con limitaciones de alcance.
Determinación de los derechos y restricciones de acceso
Cada categoría de grupos de interés requiere estructuras de permisos cuidadosamente definidas, que equilibren las necesidades de acceso con los requisitos de protección.
- Acceso de lectura: abarca quién puede ver los datos, qué elementos de datos específicos son accesibles y en qué circunstancias se concede el acceso. Los datos públicos pueden ser de libre acceso, mientras que la información confidencial de supervisión puede requerir procesos formales de autorización.
- Acceso de escritura: cubre quién puede enviar, modificar o eliminar datos, normalmente con flujos de aprobación estructurados. Las entidades que reportan suelen conservar el acceso de escritura a sus propios envíos pendientes, mientras que el personal del supervisor puede tener acceso de escritura a anotaciones internas o a sistemas de clasificación.
- Acceso administrativo: incluye la facultad de gestionar las cuentas de usuario, configurar los parámetros del sistema y modificar los parámetros de seguridad. Este nivel de acceso suele quedar restringido al personal técnico y a la alta dirección dentro de la organización del supervisor.
Las restricciones temporales agregan complejidad a la gestión del acceso. Algunos datos pueden requerir un acceso diferido, como la información confidencial de supervisión que se hace pública después de un periodo determinado. El acceso para investigación puede requerir una aprobación condicionada, mediante procesos formales de solicitud que verifiquen propósitos académicos o de política legítimos.
Las consideraciones transfronterizas pueden imponer restricciones adicionales cuando los acuerdos internacionales limitan el intercambio de datos o cuando las leyes nacionales restringen el acceso extranjero a información financiera sensible.
Implementación de las medidas de seguridad
Una vez definidos con claridad los requisitos de acceso, los supervisores pueden implementar los controles técnicos y de procedimiento adecuados para hacerlos cumplir, manteniendo la facilidad de uso del sistema.
Protección de los datos
Los mecanismos de cifrado deben proteger la información sensible tanto durante el almacenamiento como durante la transmisión. El nivel de cifrado debería corresponder a la clasificación de sensibilidad de los datos: la información confidencial de supervisión debe recibir una protección más fuerte que los datos de la información a revelar pública.
El cifrado del almacenamiento asegura que el robo físico de los medios de almacenamiento no pueda comprometer la confidencialidad de los datos. El cifrado de la transmisión protege los datos que se mueven entre sistemas o a los que acceden usuarios remotos. Los sistemas de gestión de claves deben asegurar que el cifrado siga siendo efectivo durante periodos de conservación largos y, a la vez, permitir el acceso controlado de los usuarios autorizados.
Controles de acceso
Los sistemas de permisos basados en roles hacen cumplir los requisitos de acceso identificados, al asegurar que los usuarios solo puedan acceder a los tipos de datos que corresponden a sus roles. Estos sistemas deben acomodar las estructuras de permisos complejas que requieren las distintas categorías de grupos de interés y, a la vez, seguir siendo manejables para los administradores del sistema.
Los mecanismos de verificación de identidad deben establecer de manera confiable la identidad del usuario antes de conceder el acceso. La autenticación multifactor puede ser adecuada para el acceso a datos sensibles, mientras que los sistemas de acceso público pueden apoyarse en métodos de verificación más sencillos.
Los controles de gestión de sesiones aseguran que los permisos de acceso sean válidos solo durante los periodos adecuados y que las sesiones inactivas terminen automáticamente, para evitar accesos no autorizados desde terminales desatendidas.
Integridad de los documentos
Los sistemas de almacenamiento «tal como se presentó» (as-filed) conservan los documentos originales en su forma completa y sin modificaciones, para mantener su admisibilidad legal en procesos judiciales o administrativos. Estos sistemas deben demostrar, mediante controles técnicos y de procedimiento, que los documentos almacenados siguen siendo idénticos a las versiones enviadas originalmente.
La validación de la firma digital asegura que pueda verificarse que los documentos enviados son auténticos y no han sido modificados. Los sistemas de verificación de hash pueden detectar cualquier cambio en los documentos almacenados y aportar evidencia de la integridad de los datos a lo largo del tiempo.
Los sistemas de control de versiones registran cualquier modificación autorizada y conservan los envíos originales. Cuando las entidades envían correcciones o modificaciones, el sistema debe mantener relaciones claras entre las versiones y conservar el historial completo de reportes.
Lea sobre la gestión de reportes corregidos y reenvíos en este artículo.
Medidas de rendición de cuentas
Los sistemas de auditoría integrales registran todo acceso a los datos almacenados y toda modificación de ellos mediante mecanismos detallados de registro (logs). Estos registros deben capturar el detalle suficiente para reconstruir las actividades de los usuarios y, a la vez, proteger su privacidad cuando corresponda.
Los sellos digitales y los comprobantes de envío con estampa de tiempo aportan evidencia de que documentos específicos se recibieron y procesaron en momentos determinados. Estos mecanismos soportan tanto los requisitos legales como la confianza de las entidades en el proceso de reporte.
Los sistemas de seguimiento del acceso pueden identificar patrones inusuales que indiquen brechas de seguridad, mal uso de los privilegios de acceso o problemas técnicos que requieran atención. Las alertas automáticas pueden avisar a los administradores sobre posibles problemas que deban investigarse.
Los procedimientos de auditoría periódicos deberían verificar que los controles de acceso funcionen como se espera y que los privilegios de los usuarios sigan siendo adecuados a sus roles actuales. Las revisiones periódicas pueden identificar cuentas sin uso, privilegios excesivos u otros problemas de seguridad que requieran corrección.
Estrategia de publicación y distribución
Las estrategias de publicación efectivas equilibran múltiples consideraciones, como los requisitos legales, el interés público, las necesidades de los grupos de interés y las limitaciones de recursos. Los supervisores deben establecer marcos claros para determinar qué información publicar, cuándo publicarla y en qué formatos.
Determinación del alcance de la publicación
Los requisitos legales a menudo imponen estándares mínimos de publicación y dejan margen para medidas adicionales de transparencia. Las leyes del mercado de valores suelen exigir el acceso público a los estados financieros de las empresas, mientras que la regulación bancaria puede restringir la publicación de información detallada de supervisión que podría comprometer la estabilidad financiera.
Las consideraciones de interés público van más allá de los mínimos legales y abarcan la transparencia del mercado, las necesidades de la investigación académica y los requisitos de veeduría ciudadana. Los supervisores pueden optar por publicar información adicional que apoye la eficiencia del mercado o la comprensión pública de las tendencias económicas.
Los requisitos de confidencialidad fijan límites a las decisiones de publicación. La información personal, los secretos empresariales y las evaluaciones de supervisión suelen requerir protección, mientras que los datos agregados del mercado y las tendencias anonimizadas pueden apoyar los objetivos de política pública sin comprometer intereses legítimos de privacidad.
Equilibrio entre transparencia y confidencialidad
La supresión selectiva permite publicar información útil y proteger los detalles sensibles. Los estados financieros pueden publicarse sin la información de salarios individuales, o los datos bancarios pueden divulgarse con los identificadores de las instituciones enmascarados, conservando el conocimiento a nivel de mercado.
Las técnicas de agregación y anonimización pueden aportar inteligencia de mercado valiosa sin comprometer la confidencialidad de cada entidad. Los informes de los supervisores pueden incluir tendencias de todo un sector, indicadores de riesgo o estadísticas de cumplimiento sin identificar a instituciones individuales.
La publicación diferida permite la transparencia y, a la vez, protege la información sensible para el mercado durante periodos críticos. Los hallazgos detallados de supervisión podrían publicarse después de que haya pasado el tiempo suficiente para evitar perturbaciones del mercado o perjuicios competitivos.
Entender las necesidades de los grupos de interés
Las distintas comunidades de usuarios requieren distintos formatos de datos, frecuencias de actualización y mecanismos de acceso. Los inversionistas minoristas pueden preferir resúmenes simplificados y visualizaciones, mientras que los analistas institucionales requieren datos detallados en formatos legibles por máquina.
Los investigadores suelen necesitar conjuntos de datos históricos con un formato uniforme entre periodos. Los formuladores de políticas pueden requerir tableros en tiempo real que muestren las condiciones actuales del mercado y las tendencias emergentes. Los medios de comunicación a menudo necesitan acceso oportuno a los hechos relevantes, con contexto y análisis de soporte.
Las capacidades técnicas varían mucho entre las comunidades de usuarios. Los sistemas de acceso público deben acomodar a usuarios con conocimientos técnicos limitados, mientras que las plataformas profesionales de investigación pueden suponer capacidades analíticas sofisticadas y herramientas de software especializadas.
Momento y frecuencia de la publicación
Las fechas límite de reporte crean calendarios naturales de publicación, pero los supervisores deben determinar los plazos adecuados entre el envío y la publicación. La publicación inmediata apoya la transparencia del mercado, pero puede no dejar tiempo suficiente para la validación y el aseguramiento de la calidad.
Las frecuencias de actualización deben equilibrar la oportunidad con la estabilidad del sistema. Las actualizaciones de alta frecuencia ofrecen información actual, pero pueden abrumar a los usuarios y crear retos técnicos. Las actualizaciones por lotes permiten el control de calidad, pero pueden retrasar el acceso a información sensible al tiempo.
Los calendarios de publicación por eventos pueden ser adecuados para hechos importantes, como acciones de cumplimiento coercitivo, cambios de política o perturbaciones del mercado. Estas publicaciones requieren coordinación con las estrategias generales de comunicación del supervisor, para asegurar mensajes coherentes.
Soluciones técnicas para la publicación y distribución de datos
Mecanismo de visualización de datos a la medida
Si el marco de reporte basado en XBRL se diseñó sin pensar en la visualización de los datos, debe implementarse un mecanismo de visualización (renderizado) a la medida para ofrecer versiones legibles por humanos de los datos recogidos y publicados. Los enfoques de implementación de este mecanismo varían mucho según las necesidades de los usuarios y las capacidades técnicas. Algunos receptores de datos desarrollan visores web que dan formato automáticamente a los datos XBRL en plantillas de reporte estandarizadas, lo que permite al público ver los reportes sin software XBRL especializado. Otros crean herramientas interactivas de análisis que permiten a los usuarios comparar datos entre entidades o periodos mediante interfaces personalizadas.
El enfoque de visualización a la medida da el máximo control sobre la presentación de los datos, pero requiere recursos importantes de desarrollo y mantenimiento. Los supervisores deben diseñar, construir y actualizar continuamente estos sistemas de visualización para acomodar los cambios de la taxonomía y la evolución de los requisitos de los usuarios.
A continuación hay dos ejemplos de este tipo de mecanismos de visualización a la medida.
Mecanismos de visualización basados en Inline XBRL y en Table Linkbase
Si el marco de reporte basado en XBRL usa Inline XBRL, los datos recogidos pueden publicarse tal como los reportó la entidad. En este caso, el receptor de datos no necesita desarrollar ningún mecanismo de visualización, pues de eso se encarga la empresa que prepara el reporte.
A continuación hay dos ejemplos de visualización de datos que aprovechan las capacidades de Inline XBRL. * Visor de reportes ESEF (reportes) * Visor de reportes 10-K y 10-Q de la SEC de EE. UU.
Inline XBRL no es el único mecanismo de visualización de datos. Cuando las estructuras de los datos reportados no están sujetas a ninguna modificación por parte de las entidades que reportan, el mecanismo de visualización de datos puede definirse directamente en la taxonomía mediante el mecanismo Table Linkbase. Este mecanismo lo usa la Autoridad Bancaria Europea (European Banking Authority) para visualizar los datos reportados por las instituciones financieras.
Publicación en xBRL-JSON
El formato xBRL-JSON sigue de cerca la estructura del Open Information Model (modelo abierto de información) subyacente, y la sintaxis JSON tiene amplio soporte, es liviana y es muy fácil de manejar en casi todos los lenguajes de programación. xBRL-JSON es un formato ideal para publicar datos XBRL de una manera amigable para los desarrolladores e intuitiva, incluso para quienes son nuevos en XBRL. Para los supervisores que recogen datos XBRL, publicar los datos en xBRL-JSON los hace más accesibles y reduce la barrera de entrada para los consumidores que quieren aprovechar la información estructurada. Un ejemplo es el repositorio de reportes de XBRL International, que ofrece una salida en xBRL-JSON de los reportes iXBRL presentados públicamente.
Sistemas de descarga de archivos por lotes
La distribución masiva de datos (bulk data distribution) permite a los usuarios descargar conjuntos de datos completos que cubren periodos específicos, en lugar de acceder a cada reporte por separado. Este enfoque sirve a los usuarios que requieren capacidades completas de análisis de datos, investigación o integración de sistemas sobre grandes números de entidades.
El sistema de Companies House del Reino Unido ilustra este enfoque: ofrece archivos ZIP mensuales que contienen todas las cuentas de empresas presentadas electrónicamente en ese periodo. Cada archivo mensual incluye miles de archivos XBRL e iXBRL individuales, con tamaños que dependen del volumen de reportes. El sistema mantiene una disponibilidad móvil: cada archivo mensual está accesible durante 12 meses antes de pasar al archivo histórico.
Distribución de datos mediante API
El acceso por API permite a los desarrolladores y a los usuarios de datos obtener reportes específicos de empresas, datos XBRL o conjuntos de datos puntuales mediante llamadas estructuradas a servicios web. El sistema EDGAR de la SEC de EE. UU. ilustra este enfoque: ofrece API RESTful que entregan datos en formato JSON sin requerir autenticación ni claves de API, lo que hace que los datos sean accesibles para una amplia variedad de usuarios. Otro ejemplo de este enfoque de distribución de datos mediante API es la API de reportes ESEF.
El acceso granular a los datos permite a los usuarios solicitar tipos de información específicos, como el historial de reportes de una empresa, conceptos XBRL particulares en varias empresas o datos agregados del mercado para periodos de reporte específicos. Este enfoque focalizado permite una obtención eficiente de los datos para propósitos analíticos específicos, sin descargar información innecesaria.
A menudo, la distribución de datos mediante API se ofrece junto con la integración de archivos masivos, que da un método alternativo para acceder de forma eficiente a grandes volúmenes de datos. Aunque las API permiten a los usuarios solicitar piezas específicas de información mediante llamadas individuales, este enfoque puede volverse poco práctico al analizar conjuntos de datos extensos que podrían requerir miles o millones de solicitudes separadas. Cada llamada a la API suele implicar una sobrecarga de red, tiempo de procesamiento y, con frecuencia, límites de tasa que restringen la frecuencia con que se pueden hacer solicitudes.
La integración de archivos masivos resuelve estas limitaciones al ofrecer paquetes de datos completos que evitan las restricciones de las solicitudes individuales a la API. En lugar de exigir a los usuarios hacer numerosas llamadas separadas para obtener grandes conjuntos de datos pieza por pieza, este enfoque compila conjuntos de datos completos en archivos descargables, normalmente entregados como archivos ZIP comprimidos que se actualizan con un calendario regular, a menudo cada noche.
De esa manera se superan las limitaciones de las llamadas individuales a la API para el análisis de datos a gran escala. Los archivos ZIP compilados cada noche contienen los conjuntos de datos completos de sus API, y ofrecen el método más eficiente para acceder a grandes volúmenes de datos estructurados.
Resumen
Implementar el reporte digital transforma a los supervisores, que pasan de definir políticas a ser receptores, custodios y publicadores de datos. Cada rol trae requisitos técnicos y responsabilidades operativas distintos, que influyen en las decisiones de diseño del sistema, desde la arquitectura de almacenamiento hasta los mecanismos de publicación.
Las soluciones de almacenamiento efectivas deben acomodar las características de los datos XBRL, como los beneficios de la compresión de archivos, los requisitos de cifrado y las relaciones de la taxonomía. Ya sea que se implementen sistemas basados en archivos, bases de datos relacionales o enfoques híbridos, la arquitectura debe soportar las necesidades actuales y permitir la adaptabilidad futura a medida que evolucionan los requisitos de reporte.
Proteger la información a revelar digital exige entender los diversos patrones de acceso de los grupos de interés e implementar controles adecuados para cada categoría de usuarios. Los permisos basados en roles, los estándares de cifrado y los mecanismos de auditoría deben equilibrar la accesibilidad con la protección y mantener los requisitos de admisibilidad legal.
Las estrategias de distribución deberían servir a los objetivos de transparencia sin comprometer la confidencialidad ni la estabilidad del mercado. Se pueden usar uno o más de los siguientes mecanismos: visualización a la medida, visualización (renderizado) de iXBRL, descargas por lotes o acceso mediante API. La elección depende de las comunidades de usuarios, las capacidades técnicas y los mandatos regulatorios.
Los sistemas deben acomodar taxonomías cambiantes sin exigir rediseños de fondo. Los enfoques de bases de datos basados en metadatos y las arquitecturas de almacenamiento independientes de la versión evitan migraciones costosas y preservan la comparabilidad de los datos históricos.
Los sistemas de almacenamiento y distribución deben manejar los periodos pico de reporte, las poblaciones crecientes de entidades y los requisitos analíticos en evolución, sin degradación del desempeño ni interrupciones del sistema que puedan comprometer las operaciones del supervisor.
Ya sea mediante visualización a la medida, adopción de iXBRL o transformación por API, los sistemas deben diseñarse para servir tanto al procesamiento por máquinas como al análisis por personas.
Texto original en inglés: https://playbook.xbrl.org/